
Reactで、文字をUTF-8のバイト列で表示する方法
文字列を UTF-8 のバイト列にするには、new TextEncoder().encode(文字列) を使います。返ってくる Uint8Array の1つ1つの数を toString(16) で16進数にすると、「あ」は「E3 81 82」のように表示できます。React で持つ state は、入力した文字列と表示の書き方の2つだけで、バイト列はレンダリングのたびに作ります。
ここでは、入力欄の文字をバイト列にして、全体と1文字ごとの内訳を表に出す Utf8BytesViewer という部品を作りました。書き方は16進数、2進数、%記法(%E3%81%82 の形)から選べます。
検証環境は Ubuntu 24.04、Node.js 22.23.4、Chromium 153 です。使ったのは react / react-dom 19.3.1、@types/react 19.3.0、typescript 7.0.2、esbuild 0.28.2、Playwright 1.63.0 です。.tsx を tsc で型チェックしてから esbuild で変換し、StrictMode で包んだ開発用のビルドを Playwright で操作しました。日本語入力(IME)での変換中の動き、Firefox と Safari、スマートフォン、スクリーンリーダーでの読み上げは試していません。
TextEncoder でバイト列にして、1バイトずつ文字にする
バイト列にする処理と、表示用の文字列にする処理は、utf8.ts にまとめました。
// 文字列を UTF-8 のバイト列にして、表示用の文字列にする関数

const encoder = new TextEncoder();

export type ByteFormat = 'hex' | 'binary' | 'percent';

// 1バイトを、選んだ書き方の文字列にする
export function formatByte(byte: number, format: ByteFormat): string {
  switch (format) {
    case 'hex':
      return byte.toString(16).toUpperCase().padStart(2, '0');
    case 'binary':
      return byte.toString(2).padStart(8, '0');
    case 'percent':
      return '%' + byte.toString(16).toUpperCase().padStart(2, '0');
  }
}

export function formatBytes(bytes: Uint8Array, format: ByteFormat): string {
  const sep = format === 'percent' ? '' : ' ';
  return Array.from(bytes, (b) => formatByte(b, format)).join(sep);
}

export type CharBytes = {
  char: string; // 1つのコードポイント
  codePoint: string; // U+3042 の形
  bytes: Uint8Array; // その文字の UTF-8 のバイト列
  lone: boolean; // 対になっていないサロゲート(UTF-8 にできない)
};

// for...of はコードポイントごとに回るので、絵文字も1つの要素になる
export function splitToUtf8(text: string): CharBytes[] {
  const rows: CharBytes[] = [];
  for (const char of text) {
    const cp = char.codePointAt(0)!;
    rows.push({
      char,
      codePoint: 'U+' + cp.toString(16).toUpperCase().padStart(4, '0'),
      bytes: encoder.encode(char),
      lone: cp >= 0xd800 && cp <= 0xdfff,
    });
  }
  return rows;
}

export function utf8Bytes(text: string): Uint8Array {
  return encoder.encode(text);
}
MDN の TextEncoder.encode() の説明(英語)にあるとおり、encode() は文字列を受け取り、UTF-8 で符号化した Uint8Array を返します。Uint8Array の要素は8ビットの符号なし整数(0〜255)なので、toString(16) で16進数に、toString(2) で2進数にします。0x10 未満の数は、0x05 なら 5 のように1けたになるため、padStart で2けた(2進数は8けた)にそろえています。
TextEncoder は、部品の中ではなく、ファイルの先頭で1つだけ作りました。文字ごとに encode() を呼んでも、同じ1つを使い回せます。
Chromium 153 では、Uint8Array に toHex() というメソッドもあり、「aé猫😀」のバイト列は 61c3a9e78cabf09f9880 になりました。区切りのない小文字の16進数です。検証環境の Node.js 22 には、このメソッドがありませんでした。この記事では、区切りと大文字小文字を決めたかったことと、2進数や%記法と同じ形で書きたかったことから、toString(16) で1バイトずつ作っています。
1文字が何バイトになるかは、文字によって変わる
splitToUtf8 で1文字ずつバイト列にすると、次のようになりました。
| 文字 | コードポイント | UTF-8(16進数) | バイト数 | length |
|---|---|---|---|---|
| a | U+0061 | 61 | 1 | 1 |
| é | U+00E9 | C3 A9 | 2 | 1 |
| あ | U+3042 | E3 81 82 | 3 | 1 |
| 猫 | U+732B | E7 8C AB | 3 | 1 |
| 😀 | U+1F600 | F0 9F 98 80 | 4 | 2 |
| 𠮷 | U+20BB7 | F0 A0 AE B7 | 4 | 2 |
MDN の String.length の説明にあるとおり、length は UTF-16 のコード単位の数なので、バイト数とも、見た目の文字数とも一致しません。「あ」は length が1で3バイト、「😀」は length が2で4バイトです。
何バイトになるかは、コードポイントの範囲で決まります。サロゲート(U+D800〜U+DFFF)を除く 1,112,064 個のコードポイントをすべて encode() にかけると、U+007F までが1バイト(128個)、U+07FF までが2バイト(1,920個)、U+FFFF までが3バイト(61,440個)、U+10FFFF までが4バイト(1,048,576個)でした。「あ」や「猫」は U+0800〜U+FFFF の範囲にあるので3バイトで、「𠮷」のように U+10000 以上にある漢字は4バイトになります。
2進数で見ると、先頭のバイトだけで、その文字が何バイトかが分かります。すべてのコードポイントで確かめたところ、1バイトの文字は先頭のビットが 0、2バイトの文字の先頭バイトは 110、3バイトは 1110、4バイトは 11110 で始まっていました。2バイト目以降は、どれも 10 で始まります。「あ」なら 11100011 10000001 10000010 です。部品で「2進数」を選ぶと、この形が見えます。
同じ 1,112,064 個のコードポイントを並べた文字列は、encode() してから TextDecoder で戻すと元の文字列と一致しました。1文字ずつの16進数は、Node.js の Buffer.from(文字, 'utf8') で作ったものとも一致しています。
入力欄に合わせて、全体と内訳を表に出す
import { useId, useState } from 'react';
import { formatBytes, splitToUtf8, utf8Bytes, type ByteFormat } from './utf8';

const FORMATS: { value: ByteFormat; label: string }[] = [
  { value: 'hex', label: '16進数' },
  { value: 'binary', label: '2進数' },
  { value: 'percent', label: '%記法' },
];

export function Utf8BytesViewer({ defaultValue = '' }: { defaultValue?: string }) {
  const id = useId();
  const [text, setText] = useState(defaultValue);
  const [format, setFormat] = useState<ByteFormat>('hex');

  // state は入力した文字列と書き方だけ。バイト列はレンダリングのたびに作る
  const bytes = utf8Bytes(text);
  const rows = splitToUtf8(text);

  return (
    <div className="utf8">
      <label htmlFor={id}>文字</label>
      <textarea id={id} rows={2} value={text} onChange={(e) => setText(e.target.value)} />

      <fieldset>
        <legend>バイトの書き方</legend>
        {FORMATS.map((f) => (
          <label key={f.value}>
            <input
              type="radio"
              name={`${id}-format`}
              value={f.value}
              checked={format === f.value}
              onChange={() => setFormat(f.value)}
            />
            {f.label}
          </label>
        ))}
      </fieldset>

      <p className="total">
        {rows.length} 文字(コードポイント)/<strong>{bytes.length} バイト</strong>
      </p>
      <output htmlFor={id} className="all">{formatBytes(bytes, format)}</output>

      <table>
        <thead>
          <tr>
            <th>文字</th>
            <th>コードポイント</th>
            <th>UTF-8(バイト数)</th>
          </tr>
        </thead>
        <tbody>
          {rows.map((row, i) => (
            <tr key={i} className={row.lone ? 'lone' : undefined}>
              <td>{row.char === ' ' ? '␣' : row.lone ? '(不正)' : row.char}</td>
              <td>{row.codePoint}</td>
              <td>
                {formatBytes(row.bytes, format)}
                <span className="count">({row.bytes.length})</span>
              </td>
            </tr>
          ))}
        </tbody>
      </table>
    </div>
  );
}.utf8 {
display: grid;
gap: 8px;
max-width: 480px;
}
.utf8 textarea {
font-size: 1.125rem;
padding: 6px 8px;
}
.utf8 fieldset {
display: flex;
flex-wrap: wrap;
gap: 4px 12px;
}
.utf8 .total {
margin: 0;
}
.utf8 .all {
font-family: ui-monospace, monospace;
overflow-wrap: anywhere;
padding: 6px 8px;
background: #eefafd;
}
.utf8 table {
border-collapse: collapse;
}
.utf8 th,
.utf8 td {
border: 1px solid #c8d4d9;
padding: 4px 8px;
text-align: left;
}
.utf8 td:nth-child(2),
.utf8 td:nth-child(3) {
font-family: ui-monospace, monospace;
}
.utf8 .count {
color: #067a98;
}
.utf8 tr.lone td {
color: #d85878;
}React の公式ドキュメントの「そのエフェクトは不要かも」にある、props や state から計算できる値の扱いのとおり、既存の props や state から計算できるものは state に入れず、レンダー中に計算します。この部品でも、bytes と rows は text から作れるので、state にはしていません。入力欄の文字が変わると再レンダリングされ、表も作り直されます。表の行は、入力したコードポイントの数だけ増えます。
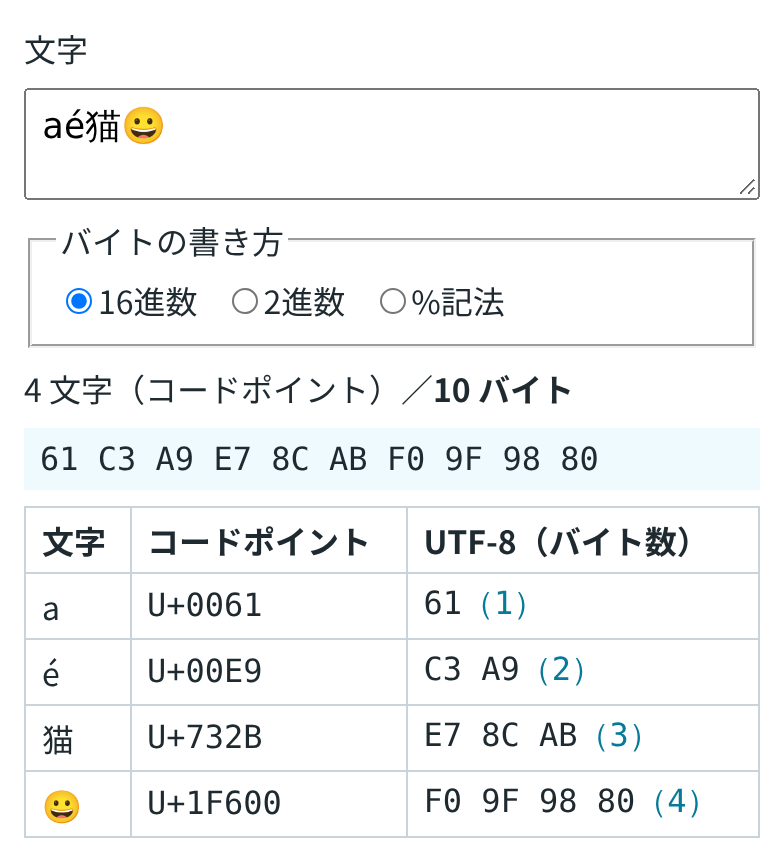
Playwright で開くと、defaultValue に渡した「aé猫😀」について「4 文字(コードポイント)/10 バイト」と出て、全体は「61 C3 A9 E7 8C AB F0 9F 98 80」でした。「2進数」を選ぶと全体も表も8けたの2進数に、「%記法」を選ぶと %61%C3%A9%E7%8C%AB%F0%9F%98%80 に変わりました。欄を空にすると「0 文字(コードポイント)/0 バイト」になり、「ねこ」と1文字ずつ打つと「2 文字(コードポイント)/6 バイト」、全体は「E3 81 AD E3 81 93」でした。どの操作のあとも、コンソールにエラーや警告は出ていません。
%記法は、encodeURIComponent とは一致しない
%記法は、MDN の用語集にあるパーセントエンコーディングの形で、% の後ろに1バイトを16進数の2けたで書きます。ただ、この部品の %記法は、すべてのバイトを %XX にします。encodeURIComponent() は、英数字と - _ . ! ~ * ' ( ) を変えずに残すので、結果が違います。
| 入力 | この部品の %記法 | encodeURIComponent |
|---|---|---|
| aé猫😀 | %61%C3%A9%E7%8C%AB%F0%9F%98%80 |
a%C3%A9%E7%8C%AB%F0%9F%98%80 |
| a b-_.!~*'() | %61%20%62%2D%5F%2E%21%7E%2A%27%28%29 |
a%20b-_.!~*'() |
日本語や絵文字の部分は、どちらも同じ %E7%8C%AB のような並びになりました。この部品の %記法の文字列を decodeURIComponent に渡すと、元の「aé猫😀」に戻ります。URL に入れる文字列を作りたいときは encodeURIComponent を使い、この部品の %記法はバイト列を見るためのものと考えてください。
表の1行は、見た目の1文字とは限らない
表は、for...of で回したときの1つずつの要素で1行にしています。MDN の String.prototypeSymbol.iterator の説明にあるとおり、for...of は文字列をコードポイントごとに回します。そのため「😀」は2つに分かれず、1行で4バイトと出ます。
一方、いくつかのコードポイントを組み合わせて1文字に見せる絵文字は、複数の行になります。家族の絵文字「👨👩👧」を入れると、「5 文字(コードポイント)/18 バイト」と出ました。表には、👨(U+1F468)、U+200D、👩(U+1F469)、U+200D、👧(U+1F467)の5行が並びます。U+200D の行は、「文字」の列に何も見えず、UTF-8 の列に「E2 80 8D(3)」と出ます。
アクセントの付いた「é」も、1つのコードポイント(U+00E9)なら「C3 A9」の2バイトですが、「e」に結合用のアクセント(U+0301)を続けた形では「65」と「CC 81」の2行、3バイトになりました。どちらも見た目は同じ1文字です。見た目の1文字ごとにまとめたいときは、Intl.Segmenter に granularity: 'grapheme' を渡して区切り、区切りごとに encode() します。Node.js で試すと、「👨👩👧」は1つの区切りで18バイト、「e」と結合用のアクセントは1つの区切りで「65 CC 81」の3バイトになりました。
対になっていないサロゲートは EF BF BD になる
"😀".slice(0, 1) のように、絵文字の途中で文字列を切ると、サロゲートペアの前半(U+D83D)だけが残ります。こうした文字は、対になっていないサロゲート(孤立サロゲート)と呼ばれます。MDN の String の説明(英語)では、英語で lone surrogate と書かれていて、UTF-8 では表せないと説明されています。
前後に「a」と「b」を付けた 'a' + '😀'.slice(0, 1) + 'b' を TextEncoder に渡すと、エラーにはならず、U+D83D の部分は EF BF BD の3バイトになりました。これは置換文字の U+FFFD「�」の UTF-8 です。TextDecoder で戻すと「a�b」になり、元の文字列には戻りません。一方、'😀'.slice(0, 1) を encodeURIComponent に渡すと、URIError: URI malformed が投げられました。
この部品では、コードポイントが U+D800〜U+DFFF の範囲にある行に lone: true を持たせ、「文字」の列に「(不正)」と書いて、行の文字をピンクにしています。defaultValue に 'a' + '😀'.slice(0, 1) + 'b' を渡して開くと、2行目は「(不正)」「U+D83D」「EF BF BD(3)」で、文字色は rgb(216, 88, 120) でした。Chromium の入力欄に Playwright の insertText で同じ文字列を入れたときは、欄の値の時点で U+D83D が U+FFFD に置き換わっていて、「(不正)」の行は出ませんでした。この表示が出るのは、コードの中で作った文字列を渡したときです。
文字列にこうした部分があるかは、isWellFormed() で調べられます。"😀".slice(0, 1).isWellFormed() は false でした。