
Reactで、camelCaseやsnake_caseを変換する方法
camelCase や snake_case を互いに変換するには、名前をいったん単語に分け、書き方ごとの決まりでつなぎ直します。単語の分け方を正規表現で決めておけば、5つの書き方のどれからでも、どれにでも変換できます。ただし、変換して戻したときに元の名前になるとは限りません。
ここでは、変換する関数と、入力した名前を5つの書き方で並べてコピーできる CaseConverter というコンポーネントを作りました。あわせて、API から受け取った JSON のキーを snake_case から camelCase にし、TypeScript の型も同じように変える関数を作りました。
検証環境は Ubuntu 24.04、Node.js 22.23.4、Chromium 153 です。使ったのは react / react-dom 19.3.1、@types/react 19.3.0、typescript 7.0.2、esbuild 0.28.2、change-case 5.4.4、Playwright 1.63.0 です。関数は Node.js で結果を確かめ、型は tsc で確かめました。コンポーネントは StrictMode で包んだ開発用のビルドを、幅 375px の Chromium で Playwright から操作しました。JSON のキーの変換は JSON.parse() の結果で確かめ、実際の API からの取得は試していません。Firefox と Safari、スマートフォンの実機での動きも試していません。
単語に分けてから、書き方ごとにつなぎ直す
5つの書き方は、単語のつなぎ方が違うだけです。
| 書き方 | 例 | つなぎ方 |
|---|---|---|
| camelCase | userName |
2つ目からの単語の先頭を大文字にして、そのままつなぐ |
| PascalCase | UserName |
すべての単語の先頭を大文字にして、そのままつなぐ |
| snake_case | user_name |
小文字にして _ でつなぐ |
| CONSTANT_CASE | USER_NAME |
大文字にして _ でつなぐ |
| kebab-case | user-name |
小文字にして - でつなぐ |
単語に分ける splitWords() と、書き方を指定して変換する convertCase() を caseConvert.ts にまとめました。
// camelCase や snake_case などの書き方を、互いに変換する関数

export type CaseStyle = 'camel' | 'pascal' | 'snake' | 'constant' | 'kebab';

// 識別子を単語に分ける
export function splitWords(input: string): string[] {
  return (
    input
      // 小文字か数字のあとに大文字が来たら分ける(userName → user Name)
      .replace(/(\p{Ll}|\p{Nd})(\p{Lu})/gu, '$1 $2')
      // 大文字が続いたあとの「大文字+小文字」の前で分ける(XMLHttp → XML Http)
      .replace(/(\p{Lu})(\p{Lu}\p{Ll})/gu, '$1 $2')
      // 文字と数字以外(_ - . 空白など)で分ける
      .split(/[^\p{L}\p{Nd}]+/u)
      .filter((w) => w !== '')
  );
}

const capitalize = (w: string) => w.charAt(0).toUpperCase() + w.slice(1);

export function convertCase(input: string, style: CaseStyle): string {
  const words = splitWords(input).map((w) => w.toLowerCase());
  switch (style) {
    case 'camel':
      return words.map((w, i) => (i === 0 ? w : capitalize(w))).join('');
    case 'pascal':
      return words.map(capitalize).join('');
    case 'snake':
      return words.join('_');
    case 'constant':
      return words.join('_').toUpperCase();
    case 'kebab':
      return words.join('-');
  }
}
\p{Lu} は大文字、\p{Ll} は小文字、\p{Nd} は数字に一致します。これらは Unicode 文字クラスエスケープと呼ばれる書き方で、正規表現に u フラグ(または v フラグ)を付けたときだけ使えます。[a-zA-Z] と書くと ASCII の英字にしか一致しませんが、この書き方なら café_au_lait の é のような文字も、単語の一部として扱えます。
単語に分けたあとは、いったんすべて小文字にしてから、書き方ごとにつなぎ直します。検証環境の Node.js で、user_name、userName、UserName、user-name、USER_NAME、user name の6つを渡すと、どれも同じ5つの結果になりました。
userName UserName user_name USER_NAME user-name略語や数字を含む名前の分かれ方
XMLHttpRequest のように大文字の略語が続く名前は、2つ目の正規表現で分けます。「大文字が続いたあとに、大文字と小文字が並んだところ」の前で分けるので、XML と Http の間で分かれます。同じ関数で、ほかの名前も変換しました。
| 元の名前 | 分かれ方 | snake_case | camelCase |
|---|---|---|---|
XMLHttpRequest |
XML / Http / Request | xml_http_request |
xmlHttpRequest |
getHTTPResponseCode |
get / HTTP / Response / Code | get_http_response_code |
getHttpResponseCode |
userID |
user / ID | user_id |
userId |
userIDs |
user / I / Ds | user_i_ds |
userIDs |
listAPIs |
list / AP / Is | list_ap_is |
listApIs |
version2Name |
version2 / Name | version2_name |
version2Name |
iPhone |
i / Phone | i_phone |
iPhone |
__private_field |
private / field | private_field |
privateField |
ユーザーID |
ユーザーID | ユーザーid |
ユーザーid |
userIDs と listAPIs は、意図しない位置で分かれました。複数形の s は小文字なので、「大文字+小文字」の前で分ける規則に当てはまり、Ds や Is が1つの単語になります。文字の並びだけでは、IDs が「ID の複数形」なのか「I と Ds」なのかを見分けられません。
ユーザーID は1つの単語のままでした。検証環境の Node.js で確かめると、ユ、ザ、ー は \p{L}(文字)には一致しますが、\p{Lu}(大文字)にも \p{Ll}(小文字)にも一致しません。そのため、1つ目の規則の「小文字のあと」に当てはまらず、ー と I の間で分かれません。そのまま全体が小文字になり、ID が id になりました。__private_field の先頭の _ は、区切りとして捨てています。
変換して戻すと、元の名前にならないことがある
一度変換した名前を、元の書き方に戻すと、次のようになりました。
userID → user_id → userId
userIDs → user_i_ds → userIDs
listAPIs → list_ap_is → listApIs
user_1_name → user1Name → user1_name
address_line_2 → addressLine2 → address_line2
camelCase の userID を snake_case にして戻すと、userId になります。snake_case の user_1_name を camelCase にすると user1Name になり、戻すと user1_name です。camelCase では数字の前後に区切りがないので、1 が前の単語に付きます。変換のたびに大文字・小文字の区別や区切りの位置が失われるので、往復させる使い方では、元の名前に戻るとは限りません。
ライブラリの change-case と比べる
書き方の変換は、change-case というライブラリにもまとまっています。上の表の名前に、html5Parser、IOSVersion、ユーザー_名前、straße_name などを加えた21個を、camelCase()、pascalCase()、snakeCase()、constantCase()、kebabCase() に渡しました。21個のうち20個で、この記事の関数と同じ結果になりました。userIDs も user_i_ds に、ユーザーID も ユーザーid になります。
違ったのは、_ の前後に数字がある user_1_name だけです。change-case の camelCase() は user_1Name を返し、数字の前の _ を残しました。そのため、snake_case に戻すと元の user_1_name になります。21個には入れていない address_line_2 でも同じで、addressLine_2 になり、戻すと元どおりでした。この記事の関数と同じ user1Name にしたいときは、camelCase('user_1_name', { mergeAmbiguousCharacters: true }) のように指定します。
もう1つ、change-case には先頭の文字を残すオプションがあります。camelCase('__typename') は typename になりますが、{ prefixCharacters: '_' } を付けると __typename のまま残りました。
入力した名前を5つの書き方で並べるコンポーネント
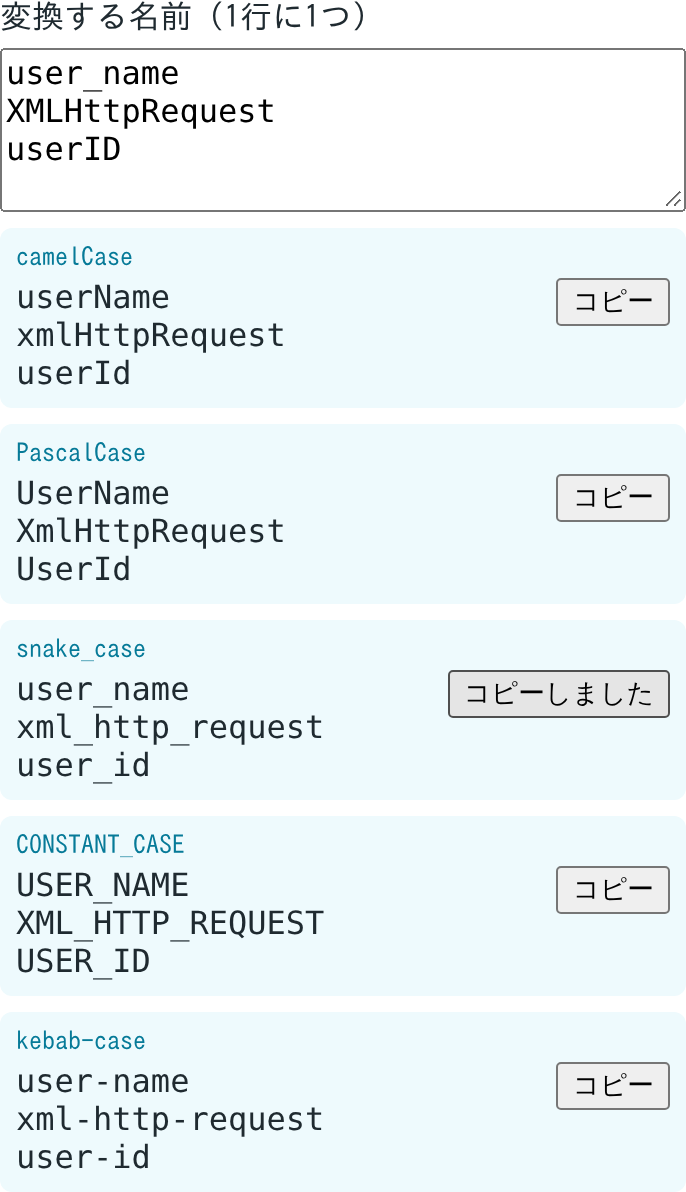
CaseConverter は、入力欄に1行に1つずつ書いた名前を、5つの書き方で並べて出します。それぞれにコピーのボタンを付けました。
import { useId, useState } from 'react';
import { convertCase, type CaseStyle } from './caseConvert';

const styles: { style: CaseStyle; label: string }[] = [
  { style: 'camel', label: 'camelCase' },
  { style: 'pascal', label: 'PascalCase' },
  { style: 'snake', label: 'snake_case' },
  { style: 'constant', label: 'CONSTANT_CASE' },
  { style: 'kebab', label: 'kebab-case' },
];

export function CaseConverter({ initial = '' }: { initial?: string }) {
  const id = useId();
  const [text, setText] = useState(initial);
  // 最後にコピーした書き方と、そのときの文字列。入力が変わったら「コピーしました」を消すために持つ
  const [copied, setCopied] = useState<{ style: CaseStyle; value: string } | null>(null);

  // 1行に1つの名前として、行ごとに変換する(空の行はそのまま残す)
  const lines = text.split('\n');

  async function copy(style: CaseStyle, value: string) {
    await navigator.clipboard.writeText(value);
    setCopied({ style, value });
  }

  return (
    <div className="case-converter">
      <label htmlFor={`${id}-input`}>変換する名前(1行に1つ)</label>
      <textarea
        id={`${id}-input`}
        rows={4}
        value={text}
        spellCheck={false}
        autoCapitalize="off"
        onChange={(e) => setText(e.target.value)}
      />
      <ul>
        {styles.map(({ style, label }) => {
          const value = lines.map((line) => convertCase(line, style)).join('\n');
          const done = copied?.style === style && copied.value === value;
          return (
            <li key={style}>
              <span className="label">{label}</span>
              <output>{value}</output>
              <button type="button" onClick={() => copy(style, value)} disabled={text.trim() === ''}>
                {done ? 'コピーしました' : 'コピー'}
              </button>
            </li>
          );
        })}
      </ul>
    </div>
  );
}.case-converter {
display: grid;
gap: 8px;
max-width: 560px;
}
.case-converter textarea {
font-family: ui-monospace, monospace;
font-size: 16px;
}
.case-converter ul {
list-style: none;
margin: 0;
padding: 0;
display: grid;
gap: 8px;
}
.case-converter li {
display: grid;
grid-template-columns: 1fr auto;
gap: 4px 8px;
padding: 8px;
background: #eefafd;
border-radius: 6px;
}
.case-converter .label {
grid-column: 1 / -1;
font-size: 13px;
color: #067a98;
}
.case-converter output {
font-family: ui-monospace, monospace;
white-space: pre;
overflow-x: auto;
}
.case-converter button {
align-self: start;
}変換した結果は state に持たず、入力した文字列からレンダーのたびに計算しています。結果を別の state に持つと、入力が変わるたびに両方をそろえる処理が要るからです。React の公式ドキュメントにも、既存の props や state から計算できるものは state に入れないという指針があります。
コピーには navigator.clipboard.writeText() を使いました。copied には、コピーした書き方と文字列の両方を持たせています。ボタンに「コピーしました」と出すのは、その書き方の今の結果が、コピーした文字列と同じときだけです。
Playwright で user_name、XMLHttpRequest、userID の3行を入力し、snake_case の結果をコピーしたところ、クリップボードには user_name\nxml_http_request\nuser_id が入り、snake_case のボタンだけが「コピーしました」になりました。続けて入力欄の末尾に s を足すと、3行目が userIDs になり、snake_case の3行目は user_i_ds に変わりました。このとき、ボタンはすべて「コピー」に戻りました。s を消すと結果がコピーした文字列と同じになり、snake_case のボタンはまた「コピーしました」になりました。
結果の <output> には white-space: pre と overflow-x: auto を付け、長い名前は枠の中で横にスクロールさせています。幅 375px の画面で get_the_very_long_http_response_status_code_from_server を入力しても、ページ全体の幅は 375px のままでした。
API の JSON のキーを、型ごと camelCase にする
API から受け取る JSON のキーが user_id のような snake_case で、React のコンポーネントでは userId と書きたい場合があります。キーを変換する関数を作るときは、TypeScript の型も同じように変えておくと、変換したあとのキーで型を付けて読めます。
// API から受け取った JSON のキーを、snake_case から camelCase にする

// 型の上での変換。最初の _ の前と後ろに分け、後ろの先頭を大文字にする
export type SnakeToCamel<S extends string> = S extends `${infer Head}_${infer Tail}`
  ? `${Head}${Capitalize<SnakeToCamel<Tail>>}`
  : S;

export type CamelizeKeys<T> = T extends readonly (infer U)[]
  ? CamelizeKeys<U>[]
  : T extends object
    ? { [K in keyof T as K extends string ? SnakeToCamel<K> : K]: CamelizeKeys<T[K]> }
    : T;

// 実行時の変換。型と同じ結果になるように、_ で分けて2つ目から先頭を大文字にする
export function snakeToCamel(key: string): string {
  const [head, ...tail] = key.split('_');
  return head + tail.map((w) => w.charAt(0).toUpperCase() + w.slice(1)).join('');
}

// JSON.parse() や response.json() の結果(配列とプレーンなオブジェクト)だけを扱う
export function camelizeKeys<T>(value: T): CamelizeKeys<T> {
  if (Array.isArray(value)) {
    return value.map((v) => camelizeKeys(v)) as CamelizeKeys<T>;
  }
  if (value !== null && typeof value === 'object') {
    return Object.fromEntries(
      Object.entries(value).map(([k, v]) => [snakeToCamel(k), camelizeKeys(v)]),
    ) as CamelizeKeys<T>;
  }
  return value as CamelizeKeys<T>;
}
SnakeToCamel は、テンプレートリテラル型で文字列の型を最初の _ の前と後ろに分け、後ろを Capitalize で先頭だけ大文字にします。後ろにまだ _ があれば、同じ型をくり返し当てはめます。CamelizeKeys は、マップ型の as でキーの名前を変え、値の型にも同じ変換をかけます。
キーの変換に convertCase() を使わない理由
実行時のキーの変換には、前の節の convertCase() ではなく、_ で分けるだけの snakeToCamel() を使いました。convertCase() は大文字の位置でも単語を分けるので、型の SnakeToCamel と結果が合わない場合があるからです。たとえば userID というキーは、convertCase() では userId になりますが、SnakeToCamel<'userID'> は _ がないので 'userID' のままです。これでは、型の上のキーは userID なのに、実際のオブジェクトのキーは userId になり、型と中身が食い違います。
検証環境では、snakeToCamel() の結果を Node.js で、SnakeToCamel の型の結果を tsc で確かめ、次のキーでどちらも同じになりました。
| キー | 変換後 |
|---|---|
user_id |
userId |
user_1_name |
user1Name |
_id |
Id |
a__b |
aB |
trailing_ |
trailing |
userID |
userID |
変換したオブジェクトを使う
入れ子のオブジェクトと配列を含む次の JSON を JSON.parse() して camelizeKeys() に渡しました。
{"user_id":1,"display_name":"ねこ","created_at":"2026-11-07T00:00:00Z","tags":[{"tag_id":3,"tag_name":"cat"}],"profile":{"avatar_url":null,"is_public":true}}結果は次のとおりです。
{"userId":1,"displayName":"ねこ","createdAt":"2026-11-07T00:00:00Z","tags":[{"tagId":3,"tagName":"cat"}],"profile":{"avatarUrl":null,"isPublic":true}}配列の中のオブジェクトや、入れ子の profile のキーも camelCase になりました。値は変えていません。
型のほうも確かめました。変換前のキーで読むと、tsc が型エラーにします。
// 変換前のキーで読もうとすると、型エラーになることを確かめる(tsc は失敗するのが正しい)
import { camelizeKeys } from './camelizeKeys';

declare const res: { user_id: number; display_name: string };
const user = camelizeKeys(res);
console.log(user.user_id);
console.log(user.displayName.toFixed());src/typecheck-error.ts(6,18): error TS2551: Property 'user_id' does not exist on type '{ displayName: string; userId: number; }'. Did you mean 'userId'?
src/typecheck-error.ts(7,30): error TS2551: Property 'toFixed' does not exist on type 'string'. Did you mean 'fixed'?user.user_id は存在しないキーとしてエラーになり、displayName は元の display_name と同じ string 型のままでした。
change-case にも、オブジェクトのキーを変換する change-case/keys があります。ただ、同梱の型定義では、camelCase() の戻り値の型は unknown でした。また、深さを指定しないと、いちばん外側のキーしか変わりません。上と同じ JSON の一部({"user_id":1,"tags":[{"tag_id":3}],"profile":{"avatar_url":null}})を渡すと {"userId":1,"tags":[{"tag_id":3}],"profile":{"avatar_url":null}} になり、2つ目の引数に 3 を渡すと、すべてのキーが camelCase になりました。変換したあとのキーを型で確かめたいときは、この記事の camelizeKeys() のように、型と実行時の変換を同じ規則で書いておくと、読み間違いを tsc が見つけてくれます。