
Reactで、文章の中の表記ゆれを見つけてそろえる方法
文章の中のカタカナ語を取り出し、半角カナを全角にする、「ヴァ」を「バ」にする、語の終わりの「ー」を除く、という3つの処理で比べるための形を作ります。比べるための形が同じなのに書き方が2つ以上ある語が、「サーバー」と「サーバ」のような表記ゆれです。「下さい」と「ください」のようにカタカナ語ではないものは、同じ意味の書き方の組を辞書にしておいて探します。
文章の中の見つけた語は <mark> で囲んで背景に色を付け、「サーバー(1回)にそろえる」のようなボタンで、ほかの書き方をまとめて置き換えます。
検証環境は Ubuntu 24.04、Node.js 22.23.4、Chromium 153 です。使ったのは react / react-dom 19.3.1、@types/react 19.3.0、typescript 7.0.2、esbuild 0.28.2、Playwright 1.63.0 です。関数の結果は Node.js で確かめ、tsc で型エラーがないことを確かめました。コンポーネントは StrictMode で包んだ開発用のビルドを、幅 375px の Chromium で Playwright から操作しました。日本語入力(IME)で打ったときの動き、Firefox と Safari、スマートフォンの実機、長い文章での処理時間は試していません。
カタカナ語を取り出して、比べるための形にそろえる
カタカナ語の表記ゆれを探す部分は次のとおりです。
// 文章の中の表記ゆれを見つけて、1つの書き方にそろえる

export type Variant = { form: string; count: number };
export type VariantGroup = {
  kind: 'katakana' | 'dictionary';
  key: string;
  variants: Variant[]; // 多く出てくる書き方から順に並べる
};

// カタカナの語。ァ〜ヺ、長音の ー、繰り返し記号の ヽ ヾ と、半角カナ(ヲ〜゚)が続く部分
const KATAKANA_WORD = /[ァ-ヺー-ヾヲ-゚]+/g;

const VU: Record<string, string> = { ヴァ: 'バ', ヴィ: 'ビ', ヴェ: 'ベ', ヴォ: 'ボ', ヴ: 'ブ' };

// 書き方の違いを消した「比べるための形」を作る
export function katakanaKey(word: string): string {
  return word
    .normalize('NFKC') // 半角カナを全角にする(サーバ → サーバ)
    .replace(/ヴ[ァィェォ]?/g, (s) => VU[s]) // ヴァイオリン → バイオリン
    .replace(/ー+$/, ''); // 語の終わりの長音を除く(サーバー → サーバ)
}

// 比べるための形が同じで、書き方が2つ以上ある語を集める
export function findKatakanaVariants(text: string): VariantGroup[] {
  const byKey = new Map<string, Map<string, number>>();
  for (const [word] of text.matchAll(KATAKANA_WORD)) {
    const key = katakanaKey(word);
    if (key.length < 2) continue; // 「ア」のような1文字の語は比べない
    const forms = byKey.get(key) ?? new Map<string, number>();
    forms.set(word, (forms.get(word) ?? 0) + 1);
    byKey.set(key, forms);
  }
  const groups: VariantGroup[] = [];
  for (const [key, forms] of byKey) {
    if (forms.size < 2) continue;
    const variants = [...forms].map(([form, count]) => ({ form, count }));
    groups.push({ kind: 'katakana', key, variants: variants.sort((a, b) => b.count - a.count) });
  }
  return groups;
}
KATAKANA_WORD は、カタカナ・長音の「ー」・半角カナが続く部分を1つの語として取り出す正規表現です。MDN の matchAll() の説明にあるとおり、matchAll() に渡す正規表現には g フラグが要ります。付けないと TypeError になります。
katakanaKey() では、最初に normalize('NFKC') をかけます。MDN の normalize() の説明にあるとおり、NFKC は互換等価な文字を同じ形にそろえる正規化で、半角カナは全角のカナになります。そのあと「ヴァ」などを「バ」などに置き換え、語の終わりの「ー」を除きます。検証環境の Node.js では、次のようになりました。
| 語 | katakanaKey() の結果 |
|---|---|
サーバー / サーバ / サーバー |
サーバ |
ヴァイオリン / バイオリン |
バイオリン |
ヴィンテージ |
ビンテージ |
コンピューター |
コンピュータ |
findKatakanaVariants() は、この形をキーにした Map で、元の書き方ごとに回数を数えます。書き方が2つ以上あるキーだけを返し、書き方は回数の多い順に並べます。「ア」と「アー」のように、比べるための形が1文字になる語は比べません。検証環境で findVariants('アとアー') を実行すると、空の配列でした。
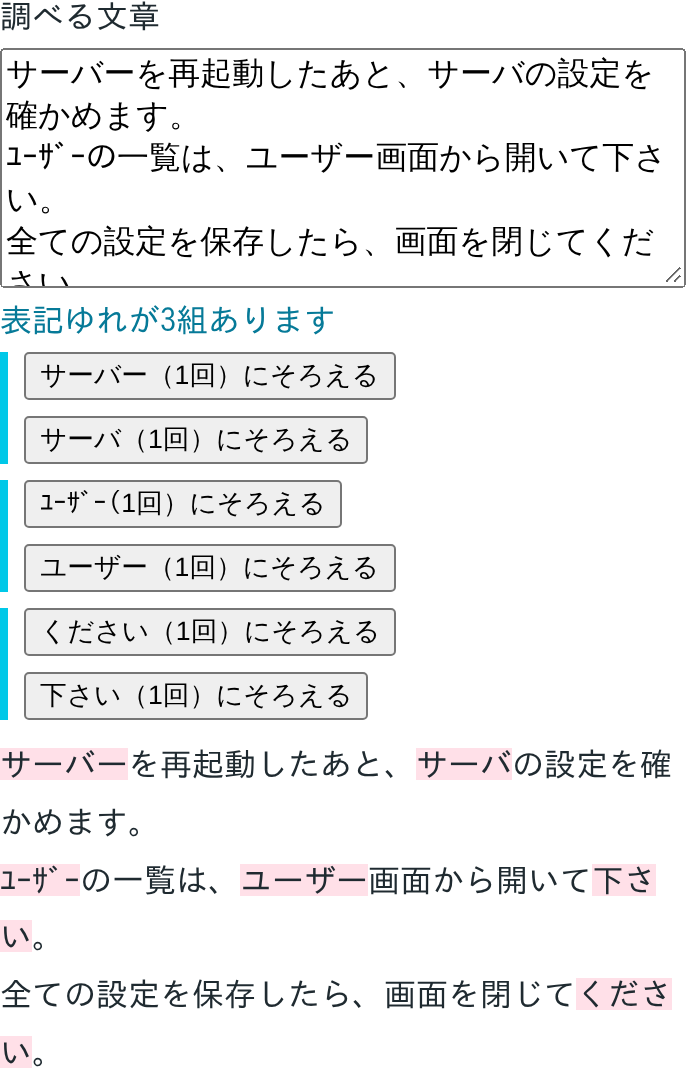
見本の文章(「サーバーを再起動したあと、サーバの設定を確かめます。」「ユーザーの一覧は、ユーザー画面から開いて下さい。」「全ての設定を保存したら、画面を閉じてください。」の3行)では、「サーバー」と「サーバ」、「ユーザー」と「ユーザー」の2組が見つかりました。辞書で見つかる「下さい」と「ください」と合わせて、3組です。
語の途中の長音は比べない
katakanaKey() で除くのは、語の終わりの「ー」だけです。そのため、「サーバーサイド」と「サーバサイド」は表記ゆれとして見つかりません。検証環境で findVariants('サーバーサイドとサーバサイド') を実行すると、空の配列でした。
語の途中の「ー」まで除けば、この2つの比べるための形は、どちらも「サバサイド」になります。ただし、「ビール」と「ビル」もどちらも「ビル」になり、別の言葉を同じ語として扱ってしまいます。そこで、この記事のコードでは語の終わりだけにしています。
中黒の「・」は KATAKANA_WORD に入れていないので、語の区切りになります。「ユーザー・インターフェース」は「ユーザー」と「インターフェース」の2語に分かれるので、「ユーザインターフェース」とは比べられません。検証環境でも、この2つを並べた文章からは何も見つかりませんでした。複合語の表記ゆれは、次の節で作る辞書に組を足して探します。
カタカナ語以外は、辞書の組で探す
「全て」と「すべて」のような表記ゆれは、文字の種類が違うので、比べるための形を作れません。同じ意味の書き方を組にした辞書を用意し、文章の中に2つ以上の書き方が出てくる組を返します。
// カタカナ以外の表記ゆれは、同じ意味の書き方の組を辞書にしておく
export const DICTIONARY: string[][] = [
  ['すべて', '全て'],
  ['ください', '下さい'],
  ['子ども', '子供'],
];

function countOf(text: string, form: string): number {
  return text.split(form).length - 1;
}

export function findDictionaryVariants(text: string, dictionary = DICTIONARY): VariantGroup[] {
  const groups: VariantGroup[] = [];
  for (const forms of dictionary) {
    const variants = forms
      .map((form) => ({ form, count: countOf(text, form) }))
      .filter((v) => v.count > 0);
    if (variants.length < 2) continue;
    groups.push({ kind: 'dictionary', key: forms[0], variants: variants.sort((a, b) => b.count - a.count) });
  }
  return groups;
}

export function findVariants(text: string): VariantGroup[] {
  return [...findKatakanaVariants(text), ...findDictionaryVariants(text)];
}
辞書の語は、文字列としてそのまま探します。そのため、短い語を辞書に入れると、別の言葉の一部を拾います。試しに ['など', '等'] の組を足して「男女平等など、等しく扱う」を調べると、「等」が2回と数えられました。「平等」と「等しく」の中の「等」です。辞書には、ほかの言葉の一部になりにくい語を入れます。
ほかの書き方を、語の単位で置き換える
ボタンを押したときに呼ぶ unify() です。
// group の書き方を、すべて to にそろえる
export function unify(text: string, group: VariantGroup, to: string): string {
  const others = group.variants.map((v) => v.form).filter((f) => f !== to);
  if (group.kind === 'katakana') {
    // カタカナの語の単位で置き換えるので、「サーバー」の中の「サーバ」は置き換えない
    return text.replace(KATAKANA_WORD, (w) => (others.includes(w) ? to : w));
  }
  return others.reduce((t, f) => t.split(f).join(to), text);
}
「サーバ」を「サーバー」に置き換えるときに、文字列の replaceAll('サーバ', 'サーバー') を使うと、もとから「サーバー」だった部分の「サーバ」も置き換わります。見本の文章で試したところ、1行目の先頭が「サーバーーを再起動したあと」になりました。
unify() では、カタカナ語の組は KATAKANA_WORD で語ごとに取り出し、語の全体がほかの書き方と同じときだけ置き換えます。見本の文章で「サーバー」にそろえると、「サーバーを再起動したあと、サーバーの設定を確かめます。」になり、長音が重なることはありませんでした。辞書の組は split() と join() で置き換えます。
見つけた語を <mark> で囲む
文章を表示するときに、表記ゆれの語だけを <mark> で囲めるように、文章を区切る関数です。
export type Segment = { text: string; mark: boolean };

const escape = (s: string) => s.replace(/[.*+?^${}()|[\]\\]/g, '\\$&');

// 表記ゆれの語を <mark> で囲んで表示するために、文章を区切る
export function highlight(text: string, groups: VariantGroup[]): Segment[] {
  const katakana = new Set<string>();
  const dictionary: string[] = [];
  for (const g of groups) {
    for (const v of g.variants) {
      if (g.kind === 'katakana') katakana.add(v.form);
      else dictionary.push(v.form);
    }
  }
  const pattern = [KATAKANA_WORD.source, ...dictionary.map(escape)].join('|');
  const segments: Segment[] = [];
  let last = 0;
  for (const m of text.matchAll(new RegExp(pattern, 'g'))) {
    const word = m[0];
    if (!katakana.has(word) && !dictionary.includes(word)) continue;
    if (m.index > last) segments.push({ text: text.slice(last, m.index), mark: false });
    segments.push({ text: word, mark: true });
    last = m.index + word.length;
  }
  if (last < text.length) segments.push({ text: text.slice(last), mark: false });
  return segments;
}
カタカナ語の正規表現と辞書の語を | でつないだ1つの正規表現で、文章を先頭から調べます。カタカナ語は語の全体で比べるので、「サーバー」の中の「サーバ」だけが囲まれることはありません。辞書の語は、正規表現の中で特別な意味を持つ記号を escape() でエスケープしてからつなぎます。
一覧とボタンを出すコンポーネント
コンポーネントは次のとおりです。state は文章の1つだけで、表記ゆれの一覧と区切った文章は、文章から useMemo で計算します。
import { useId, useMemo, useState } from 'react';
import { findVariants, highlight, unify } from './variants';

export function VariantChecker({ initial = '' }: { initial?: string }) {
  const id = useId();
  const [text, setText] = useState(initial);
  const groups = useMemo(() => findVariants(text), [text]);
  const segments = useMemo(() => highlight(text, groups), [text, groups]);

  return (
    <div className="variant-checker">
      <label htmlFor={id}>調べる文章</label>
      <textarea id={id} rows={6} value={text} onChange={(e) => setText(e.target.value)} />
      <p role="status">
        {groups.length === 0 ? '表記ゆれは見つかりませんでした' : `表記ゆれが${groups.length}組あります`}
      </p>
      <ul className="groups">
        {groups.map((g) => (
          <li key={`${g.kind}:${g.key}`}>
            {g.variants.map((v) => (
              <button key={v.form} type="button" onClick={() => setText(unify(text, g, v.form))}>
                {v.form}({v.count}回)にそろえる
              </button>
            ))}
          </li>
        ))}
      </ul>
      <p className="preview">
        {segments.map((s, i) => (s.mark ? <mark key={i}>{s.text}</mark> : s.text))}
      </p>
    </div>
  );
}.variant-checker { display: grid; gap: 8px; max-width: 480px; }
.variant-checker textarea { font-size: 16px; }
.variant-checker [role='status'] { margin: 0; color: #067a98; }
.variant-checker .groups { display: grid; gap: 8px; margin: 0; padding: 0; list-style: none; }
.variant-checker .groups li { display: flex; flex-wrap: wrap; gap: 8px; padding-left: 8px; border-left: 4px solid #00c8e8; }
.variant-checker .preview { margin: 0; white-space: pre-wrap; line-height: 1.8; }
.variant-checker mark { background: #ffe0e8; color: inherit; }見本の文章を初期値にして、Playwright で操作しました。最初は「表記ゆれが3組あります」と出て、「サーバー」「サーバ」「ユーザー」「ユーザー」「下さい」「ください」の6か所が <mark> で囲まれました。「全て」は、文章の中に「すべて」がないので、表記ゆれになりません。
「サーバー(1回)にそろえる」を押すと、1行目の「サーバの設定」の「サーバ」が「サーバー」になり、表示は「表記ゆれが2組あります」に変わりました。続けて「ユーザー(1回)にそろえる」「ください(1回)にそろえる」を押すと、「表記ゆれは見つかりませんでした」になり、<mark> で囲まれた語はなくなりました。そのあと入力欄に「すべて」と打ち足すと、「全て」との組ができて「表記ゆれが1組あります」に戻りました。
幅 375px の画面で、横にはみ出す要素はありませんでした(scrollWidth は 375)。ブラウザのコンソールに、エラーと警告は出ませんでした。