
Reactで、全角と半角を変換する入力欄を作る方法
全角と半角の変換は、英数字と記号なら文字コードを 0xFEE0 ずらすだけで済みます。手間がかかるのはカタカナで、「ガ」の2文字を「ガ」の1文字にまとめる処理が要ります。これは normalize('NFKC') に任せられますが、文字列全体にかけると「①」や「㈱」まで変わってしまうので、半角カナの部分にだけかけました。
ここでは、変換する種類(英数字・記号・カタカナ・スペース)を選び、ボタンで全角か半角にそろえる ZenHanConverter という部品を作りました。変換の処理は zenhan.ts にまとめ、郵便番号の欄を離れたときに半角にする使い方も添えています。
検証環境は Ubuntu 24.04、Node.js 22.23.4、Chromium 153 です。使ったのは react / react-dom 19.3.1、@types/react 19.3.0、typescript 7.0.2、esbuild 0.28.2、Playwright 1.63.0 です。.tsx を esbuild で変換し、tsc で型エラーがないことを確かめたうえで、StrictMode で包んだ開発用のビルドを Playwright で操作しました。日本語入力(IME)での変換中の動き、Firefox と Safari、スマートフォン、スクリーンリーダーでの読み上げは試していません。
変換の関数をまとめたファイル
// 全角と半角を、選んだ種類の文字だけ変換する関数

export type Kinds = {
  alnum: boolean; // 英数字(0-9 A-Z a-z)
  symbol: boolean; // 記号(! から ~ までの英数字以外)
  kana: boolean; // カタカナと「。」「、」「・」「ー」など
  space: boolean; // スペース
};

export const ALL: Kinds = { alnum: true, symbol: true, kana: true, space: true };

// 半角の英数字・記号と、全角の英数字・記号は、文字コードが 0xFEE0 ずれている
const OFFSET = 0xfee0;
const isAlnum = (c: string) => /[0-9A-Za-z]/.test(c);

// 半角カナ(U+FF61〜U+FF9F)と全角の対応表を、Unicode の正規化から作る
const kanaToHalf = new Map<string, string>();
for (let cp = 0xff61; cp <= 0xff9f; cp++) {
  const half = String.fromCodePoint(cp);
  kanaToHalf.set(half.normalize('NFKC'), half);
}
// 単独の濁点・半濁点(゛゜)も半角の ゙ ゚ にする
kanaToHalf.set('゛', '゙');
kanaToHalf.set('゜', '゚');
// ガ・パ・ヴなどは、NFD で「カ+濁点」に分けてから、半角の2文字にする
for (let cp = 0x30a1; cp <= 0x30fa; cp++) {
  const full = String.fromCodePoint(cp);
  if (kanaToHalf.has(full)) continue;
  const [base, mark] = full.normalize('NFD');
  const halfBase = kanaToHalf.get(base);
  if (halfBase && (mark === '゙' || mark === '゚')) {
    kanaToHalf.set(full, halfBase + (mark === '゙' ? '゙' : '゚'));
  }
}
const FULL_KANA = new RegExp(`[${[...kanaToHalf.keys()].join('')}]`, 'g');

export function toHankaku(text: string, kinds: Kinds = ALL): string {
  let s = text.replace(/[!-~]/g, (c) => {
    const half = String.fromCharCode(c.charCodeAt(0) - OFFSET);
    const use = isAlnum(half) ? kinds.alnum : kinds.symbol;
    return use ? half : c;
  });
  if (kinds.space) s = s.replace(/ /g, ' ');
  if (kinds.kana) s = s.replace(FULL_KANA, (c) => kanaToHalf.get(c)!);
  return s;
}

export function toZenkaku(text: string, kinds: Kinds = ALL): string {
  let s = text.replace(/[\x21-\x7e]/g, (c) => {
    const use = isAlnum(c) ? kinds.alnum : kinds.symbol;
    return use ? String.fromCharCode(c.charCodeAt(0) + OFFSET) : c;
  });
  if (kinds.space) s = s.replace(/ /g, ' ');
  if (kinds.kana) {
    // 半角カナの並びを NFKC でまとめて全角にする(ガ → ガ)
    s = s.replace(/[。-゚]+/g, (run) =>
      run
        .normalize('NFKC')
        // くっつく相手のない濁点・半濁点は、結合文字のまま残さず ゛゜ にする
        .replace(/゙/g, '゛')
        .replace(/゚/g, '゜'),
    );
  }
  return s;
}
半角の「!」(U+0021)から「~」(U+007E)までの文字は、全角の「!」(U+FF01)から「~」(U+FF5E)までと、同じ順に並んでいます。そのため、文字コードに 0xFEE0 を足せば全角に、引けば半角になります。英数字か記号かは、半角にした文字が 0-9A-Za-z に入るかどうかで分けました。スペースだけは並びの外にあるので、半角の空白(U+0020)と全角の空白(U+3000)を別に置き換えています。
カタカナは、正規化を使って対応表を作る
カタカナは、文字コードの並びが半角と全角で一致しません。そこで、半角カナの「。」(U+FF61)から「゚」(U+FF9F)までの63文字に normalize('NFKC') をかけ、全角の文字から半角の文字を引ける表を作りました。MDN の normalize() の説明にあるとおり、NFKC は互換等価性で分解してから合成し直す形式です。半角の「カ」は全角の「カ」に、「「」は「「」に、「ー」は「ー」になります。
「ガ」や「パ」は、半角では「ガ」「パ」の2文字です。表にない全角のカタカナは、normalize('NFD') で「カ」と濁点(U+3099)に分け、分けた「カ」が表にあれば、半角の「カ」に「゙」を付けた2文字を登録しました。逆に全角にするときは、半角カナが続いている部分をまとめて normalize('NFKC') に渡すと、「ガ」が1文字の「ガ」になります。
zenhan.ts を Node.js で動かすと、次のようになりました。
| 入力 | 関数 | 結果 |
|---|---|---|
| ガイドブック | toHankaku |
ガイドブック |
| パン・ヴァイオリン | toHankaku |
パン・ヴァイオリン |
| 「。、」ー | toHankaku |
「。、」ー |
| パン・ヴァイオリン | toZenkaku |
パン・ヴァイオリン |
| (株)サンプル ショウジ | toZenkaku |
(株)サンプル ショウジ |
| ABC123 | toHankaku |
ABC123 |
半角カナの63文字と、濁点・半濁点が付いて1文字にまとまる28組を、全角にしてから半角に戻すと、すべて元の文字列に戻りました。半角の「!」から「~」までとスペースの95文字も、同じように往復させて元に戻りました。
全角のカタカナのうち、「ヮ」「ヰ」「ヱ」「ヵ」「ヶ」「ヸ」「ヹ」の7文字は、半角にならずに全角のまま残ります。表を作ったもとの半角カナの63文字に、これらに当たる文字がないためです。
normalize('NFKC') を文字列全体にかけない理由
全角の英数字を半角にするだけなら、normalize('NFKC') を1回かけるのがいちばん短い書き方です。ただ、NFKC は全角と半角以外の文字も変えます。検証環境の Node.js で、NFKC と、この記事の関数とを比べました。
| 入力 | normalize('NFKC') |
toZenkaku |
toHankaku |
|---|---|---|---|
| ①㈱㌔ | 1(株)キロ | ①㈱㌔ | ①㈱㌔ |
| ア゙ | ア゙(ア+結合用の濁点) | ア゛ | ア゙ |
| ゙カ | ゙カ(結合用の濁点+カ) | ゛カ | ゙カ |
| ~ | ~ | ~ | ~ |
| ¥ | ¥ | ¥ | ¥ |
NFKC は、丸数字の「①」を「1」に、「㈱」を「(株)」の3文字に、「㌔」を「キロ」の2文字に変えました。全角と半角をそろえたいだけなのに、文字の数や見た目まで変わります。
もう1つの違いは、「ア゙」のように、前の文字と1文字にまとまらない濁点の扱いです。NFKC の結果は、「ア」(U+30A2)と結合用の濁点(U+3099)の2文字になりました。toZenkaku では、残った結合用の濁点を、単独で使う「゛」(U+309B)に置き換えています。
「~」(U+FF5E、全角のチルダ)は半角の「~」になりますが、「〜」(U+301C、波ダッシュ)は別の文字なので、toZenkaku でも toHankaku でも変わりません。「¥」(U+FFE5)も、0xFEE0 ずらした並びの外にあるので、そのまま残ります。半角の「\」(U+005C)の全角は「\」(U+FF3C)です。それぞれの文字が何かは、Python の unicodedata で文字の名前を表示して確かめました。
種類を選んでボタンで変換する部品
import { useId, useState } from 'react';
import { toHankaku, toZenkaku, type Kinds } from './zenhan';

const LABELS: Record<keyof Kinds, string> = {
  alnum: '英数字',
  symbol: '記号',
  kana: 'カタカナ',
  space: 'スペース',
};

export function ZenHanConverter({ defaultValue = '' }: { defaultValue?: string }) {
  const id = useId();
  const [text, setText] = useState(defaultValue);
  const [kinds, setKinds] = useState<Kinds>({ alnum: true, symbol: true, kana: true, space: true });
  const [message, setMessage] = useState('');

  const run = (convert: (s: string, k: Kinds) => string, label: string) => {
    const next = convert(text, kinds);
    setMessage(next === text ? `${label}にする文字はありませんでした` : `${label}にしました`);
    setText(next);
  };

  return (
    <div className="zenhan">
      <label htmlFor={id}>変換する文字</label>
      <textarea
        id={id}
        rows={3}
        value={text}
        onChange={(e) => {
          setText(e.target.value);
          setMessage('');
        }}
      />
      <fieldset>
        <legend>変換する種類</legend>
        {(Object.keys(LABELS) as (keyof Kinds)[]).map((key) => (
          <label key={key}>
            <input
              type="checkbox"
              checked={kinds[key]}
              onChange={(e) => setKinds({ ...kinds, [key]: e.target.checked })}
            />
            {LABELS[key]}
          </label>
        ))}
      </fieldset>
      <div className="buttons">
        <button type="button" onClick={() => run(toZenkaku, '全角')}>全角にする</button>
        <button type="button" onClick={() => run(toHankaku, '半角')}>半角にする</button>
      </div>
      <output htmlFor={id} aria-live="polite">{message}</output>
    </div>
  );
}.zenhan {
display: grid;
gap: 8px;
max-width: 360px;
}
.zenhan textarea {
font-size: 1.125rem;
padding: 6px 8px;
}
.zenhan fieldset {
display: flex;
flex-wrap: wrap;
gap: 4px 12px;
}
.zenhan .buttons {
display: flex;
gap: 8px;
}
.zenhan button {
font-size: 1rem;
padding: 6px 12px;
}
.zenhan output {
min-height: 1.5em;
color: #067a98;
}<textarea> は、value と onChange を渡した制御されたテキストエリアです。公式リファレンスにあるとおり、onChange は入力値が変わるたびに呼ばれます。この部品では onChange では変換せず、打った文字をそのまま state に入れ、ボタンを押したときだけ toZenkaku か toHankaku を通します。
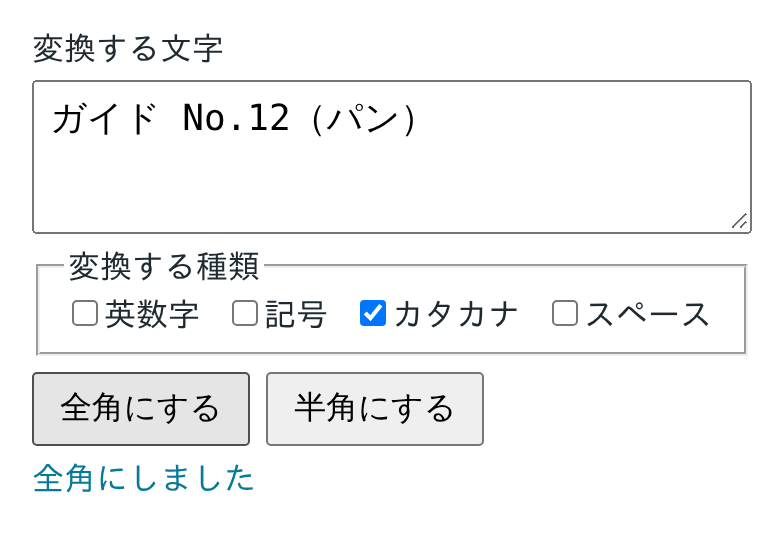
defaultValue に「ガイド No.12(パン)」を渡して Playwright で開き、カタカナだけにチェックを残して「全角にする」を押すと、欄は「ガイド No.12(パン)」になり、「全角にしました」と出ました。英数字と「()」は、そのまま残っています。もう一度押すと、欄は変わらず「全角にする文字はありませんでした」と出ました。
欄の文字を書き換えると(ここでは空にして「ABC 123」と1文字ずつ打つと)、ボタンの下の「全角にする文字はありませんでした」は消え、打った文字はそのまま残りました。すべての種類にチェックを入れて「半角にする」を押すと、「ABC 123」になりました。
郵便番号の欄は、離れたときに半角にそろえる
1つの欄を決まった形にそろえたいときは、ボタンを置かずに、欄を離れたとき(onBlur)に変換する書き方もできます。郵便番号では、英数字と記号だけを半角にしました。カタカナとスペースは変換の対象から外します。
ただ、toHankaku だけでは、区切りの文字が半角の「-」にならないことがあります。郵便番号の欄と同じ指定(英数字と記号だけ)で toHankaku を通すと、全角の「-」(U+FF0D)は「-」になりました。一方、区切りに長音の「ー」(U+30FC)を使った「123ー4567」は「123ー4567」になり、「ー」が残りました。「ー」はハイフンではなくカタカナの長音で、この指定ではカタカナを変換しないためです(カタカナも対象にすると、半角の「ー」になりました)。マイナス記号の「−」(U+2212)とハイフンの「‐」(U+2010)も、0xFEE0 ずらす並びの外にあるため残りました。
そこで、次の表の文字を、どれも半角の「-」(U+002D)にそろえることにしました。全角の「-」は toHankaku で変わり、それ以外は半角にしたあとの置き換えで変えます。文字の名前は、Python の unicodedata で表示して確かめたものです。
| 文字 | コード | 文字の名前 | どこで変わるか |
|---|---|---|---|
| - | U+FF0D | FULLWIDTH HYPHEN-MINUS | toHankaku(0xFEE0 ずらす) |
| ‐ | U+2010 | HYPHEN | replace(HYPHEN_LIKE, '-') |
| ‑ | U+2011 | NON-BREAKING HYPHEN | replace(HYPHEN_LIKE, '-') |
| ‒ | U+2012 | FIGURE DASH | replace(HYPHEN_LIKE, '-') |
| – | U+2013 | EN DASH | replace(HYPHEN_LIKE, '-') |
| — | U+2014 | EM DASH | replace(HYPHEN_LIKE, '-') |
| ― | U+2015 | HORIZONTAL BAR | replace(HYPHEN_LIKE, '-') |
| − | U+2212 | MINUS SIGN | replace(HYPHEN_LIKE, '-') |
| ー | U+30FC | KATAKANA-HIRAGANA PROLONGED SOUND MARK | replace(HYPHEN_LIKE, '-') |
| ー | U+FF70 | HALFWIDTH KATAKANA-HIRAGANA PROLONGED SOUND MARK | replace(HYPHEN_LIKE, '-') |
見た目が似ていて区別しにくいので、正規表現の中では、文字そのものではなく \u2010 のように文字コードで書いています。変換の処理は normalizePostalCode という関数に分け、最後に trim() で前後の空白を取り除きます。
import { useId, useState } from 'react';
import { toHankaku } from './zenhan';

// ハイフンに見える文字:‐ ‑ ‒ – — ―(U+2010〜U+2015)、−(U+2212)、ー(U+30FC)、ー(U+FF70)
const HYPHEN_LIKE = /[\u2010-\u2015\u2212\u30fc\uff70]/g;

// 英数字と記号だけ半角にし、ハイフンに見える文字を半角の「-」にそろえる
export function normalizePostalCode(value: string): string {
  return toHankaku(value, { alnum: true, symbol: true, kana: false, space: false })
    .replace(HYPHEN_LIKE, '-')
    .trim();
}

// 郵便番号の欄。欄を離れたときに、半角の数字と「-」にそろえる
export function PostalCodeInput() {
  const id = useId();
  const [value, setValue] = useState('');

  return (
    <div className="postal">
      <label htmlFor={id}>郵便番号</label>
      <input
        id={id}
        type="text"
        inputMode="numeric"
        value={value}
        onChange={(e) => setValue(e.target.value)}
        onBlur={() => setValue(normalizePostalCode(value))}
      />
    </div>
  );
}
Playwright で「123-4567 」(最後に半角の空白)を打つと、打った直後の欄は打ったとおりでした。Tab キーで欄を離れると「123-4567」になり、最後の空白も trim() で消えました。
区切りを表の10種類の文字に変えて試すと、どれも欄を離れたあとは「123-4567」になりました。「123ー4567」も「123−4567」も同じです。