
Reactで、長い文章を決めた文字数ごとに分ける方法
長い文章を決めた文字数ごとに分けるには、まず文章を見た目の1文字ずつに分け、上限の字数ごとにまとめ直します。文の途中で切れるのを避けたいときは、文の切れ目で区切ってから、上限に収まるだけの文を1つにまとめます。
ここでは、入力欄に入れた文章を「1つあたり何字まで」で分け、それぞれをコピーできる TextSplitter というコンポーネントを作りました。文の切れ目で分けるかどうかと、「(1/4)」のような番号を付けるかどうかを選べます。
検証環境は Ubuntu 24.04、Node.js 22.23.4、Chromium 153 です。使ったのは react / react-dom 19.3.1、@types/react 19.3.0、typescript 7.0.2、esbuild 0.28.2、Playwright 1.63.0 です。分ける関数は Node.js で結果を確かめ、コンポーネントは tsc で型エラーがないことを確かめたうえで、StrictMode で包んだ開発用のビルドを幅 375px の Chromium で Playwright から操作しました。Firefox と Safari、スマートフォンの実機、英語など日本語以外の文章の分け方は試していません。
文章を分ける関数
分ける処理は、splitText.ts にまとめました。splitText() は番号なしで分け、splitWithNumbers() は番号を付けて分けます。どちらも分けたあとの文字列の配列を返します。
// 長い文章を、決めた文字数ごとに分ける関数

export type SplitMode = 'chars' | 'sentence';

const graphemes = new Intl.Segmenter('ja', { granularity: 'grapheme' });
const sentences = new Intl.Segmenter('ja', { granularity: 'sentence' });

// 見た目の1文字(書記素)ごとに分ける
function toGraphemes(text: string): string[] {
  return Array.from(graphemes.segment(text), (s) => s.segment);
}

export function countChars(text: string): number {
  return toGraphemes(text).length;
}

// 文字数ちょうどで分ける
function splitByChars(text: string, max: number): string[] {
  const chars = toGraphemes(text);
  const chunks: string[] = [];
  for (let i = 0; i < chars.length; i += max) {
    chunks.push(chars.slice(i, i + max).join(''));
  }
  return chunks;
}

// 文に分ける。Intl.Segmenter の区切りを、かぎかっこに合わせて2か所だけ直す
export function toSentences(text: string): string[] {
  const list: string[] = [];
  let carry = '';
  for (const { segment } of sentences.segment(text)) {
    let s = carry + segment;
    carry = '';
    // 文の末尾に付いた開きかっこ(「本当?「」の「)は、次の文の頭へ移す
    const open = s.match(/[「『(【]+$/);
    if (open && open[0].length < s.length) {
      carry = open[0];
      s = s.slice(0, -carry.length);
    }
    // 閉じかっこで終わる文(「はい。」)は、改行が来るまで次の文(と言った。)とつなげる
    const prev = list.at(-1);
    if (prev !== undefined && /[」』)】]$/.test(prev)) {
      list[list.length - 1] = prev + s;
    } else {
      list.push(s);
    }
  }
  if (carry) list.push(carry);
  return list;
}

// 文の切れ目で、max 字に収まるだけ文を詰める。1文で max 字を超えるときは、その文だけ文字数で分ける
function splitBySentence(text: string, max: number): string[] {
  const chunks: string[] = [];
  let current = '';
  let currentLength = 0;
  for (const sentence of toSentences(text)) {
    const length = toGraphemes(sentence).length;
    if (currentLength + length <= max) {
      current += sentence;
      currentLength += length;
      continue;
    }
    if (current) chunks.push(current);
    if (length <= max) {
      current = sentence;
      currentLength = length;
    } else {
      const parts = splitByChars(sentence, max);
      current = parts.pop()!;
      currentLength = toGraphemes(current).length;
      chunks.push(...parts);
    }
  }
  if (current) chunks.push(current);
  return chunks;
}

export function splitText(text: string, max: number, mode: SplitMode = 'chars'): string[] {
  if (max < 1) return [];
  const normalized = text.replace(/\r\n?/g, '\n');
  return mode === 'sentence' ? splitBySentence(normalized, max) : splitByChars(normalized, max);
}

// 「(1/3)」のような番号を付けても max 字に収まるように分ける。番号だけで max 字を超えるときは空の配列を返す
export function splitWithNumbers(text: string, max: number, mode: SplitMode = 'chars'): string[] {
  let total = 1;
  for (;;) {
    // 番号がいちばん長くなるのは「(3/3)」のように最後の1つ
    const bodyLength = max - countChars(`(${total}/${total})`);
    if (bodyLength < 1) return [];
    const chunks = splitText(text, bodyLength, mode);
    if (String(chunks.length).length === String(total).length) {
      return chunks.map((c, i) => `${c}(${i + 1}/${chunks.length})`);
    }
    // total は減らさず、桁数が増える向きにだけ進める
    total = Math.max(total, chunks.length);
  }
}
文字数は Intl.Segmenter で数える
文字列の length や slice() の位置は、UTF-16 のコード単位で数えます。絵文字や国旗のように、見た目は1字でも中身が2単位以上の文字は、途中で切れてしまいます。Node.js で '👨👩👧🇯🇵か゚猫' を2字ずつに分けて比べました。
| 分け方 | 結果 |
|---|---|
slice(i, i + 2) |
8個。家族の絵文字は「👨」「👧」と、壊れた文字を含む2つの断片の4つに分かれ、国旗も「🇯」「🇵」に分かれる |
splitText(text, 2) |
2個。「👨👩👧🇯🇵」と「か゚猫」 |
そこで Intl.Segmenter を granularity: 'grapheme' で使い、見た目の1文字(書記素)ごとに分けてから数えています。家族の絵文字と国旗を並べた「👨👩👧🇯🇵」は、length では12ですが、countChars() では2字です。
改行も1字として数えます。Intl.Segmenter は \r\n を、\r と \n に分けずに1字として扱いました。splitText() は最初に \r\n を \n に置き換えます。'あい\r\nうえ\nお' を3字ずつに分けると、「あい(改行)」「うえ(改行)」「お」の3個になりました。
文の切れ目で分けると、文の途中で切れない
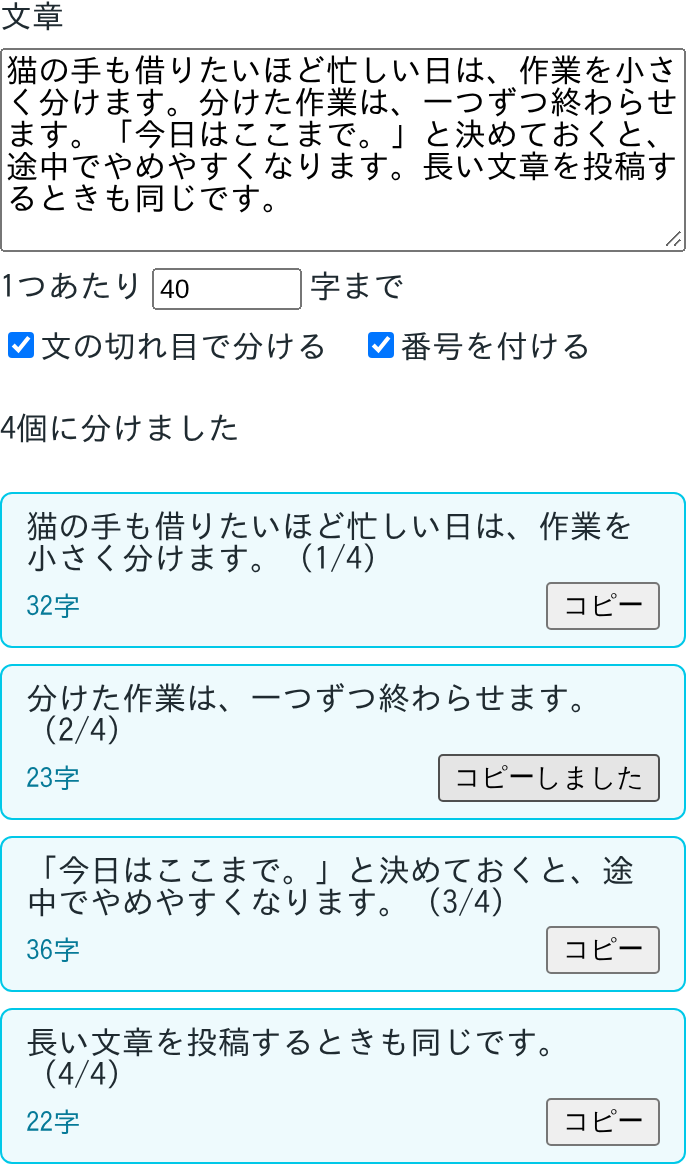
文字数ちょうどで分けると、文の途中でも切れます。画面の見本の93字の文章を、番号付き・40字までで分けた結果を比べます。
| 分け方 | 結果 |
|---|---|
| 文字数ちょうど | 3個。1個目は「…分けた作業は、一(1/3)」で終わり、2個目は「つずつ終わらせます。…」から始まる |
| 文の切れ目 | 4個。どれも「。」のあとで切れ、いちばん長いものは36字 |
文の切れ目で分けるときは、granularity: 'sentence' の Intl.Segmenter で文に分け、上限を超えるまで文を詰めていきます。数が1個増えるかわりに、どれも文の終わりで切れました。
1つの文だけで上限を超えるときは、その文だけを文字数ちょうどで分けます。'短い文。これはとても長い一つの文なので八字には入りません。終わり。' を8字までで分けると、「短い文。」「これはとても長い」「一つの文なので八」「字には入りません」「。終わり。」の5個になりました。長い文の最後の「。」が、次の文と一緒になっています。
かぎかっこの前後は、Intl.Segmenter の区切りを直す
Intl.Segmenter の文の区切りは、日本語のかぎかっこの前後で、文としては不自然な位置に入ります。この現象と、句点とかっこを見て自分で文を区切る方法は、「Reactで、1文の長さを数えて長い文を目立たせる方法」で詳しく扱いました。この記事では、文字数で分ける処理に必要な2か所だけを toSentences() で直しています。
| 文章 | Intl.Segmenter のまま |
toSentences() で直したあと |
|---|---|---|
| 本当?「はい。」と言った。 | 本当?「
はい。」
と言った。 |
本当?
「はい。」と言った。 |
| 「今日はここまで。」と決めておく。 | 「今日はここまで。」
と決めておく。 |
「今日はここまで。」と決めておく。 |
| 「はい。」(改行)次の行。 | 「はい。」(改行)
次の行。 |
区切りは変わらない |
1つ目の 本当?「 のように文の末尾に付いた開きかっこは、次の文の頭に移します。2つ目のように閉じかっこで終わる文は、次の文とつなげます。3つ目のように閉じかっこのあとに改行があるときは、文が改行で終わるので、区切りを残します。
比べるため、Intl.Segmenter の区切りをそのまま使って、見本の文章を番号なし・40字までで詰めました。すると2個目が「…終わらせます。「今日はここまで。」」で終わり、3個目が「と決めておくと、…」から始まりました。splitText() では、「「今日はここまで。」と決めておくと、途中でやめやすくなります。」が1個にまとまりました。
番号を付けても、上限に収まるようにする
「(1/4)」のような番号を付けると、そのぶん字数が増えます。番号の長さは全体の個数の桁数で変わり、全体の個数は番号の長さで変わります。そこで splitWithNumbers() では、桁数が変わらなくなるまで分け直しています。
100字の文章を、番号込みで12字までに分けたときの流れです。
- 番号を「(1/1)」の5字とみて、7字ずつに分けると15個
- 番号を「(15/15)」の7字とみて、5字ずつに分けると20個。桁数が2桁のまま変わらないので、ここで決まり
最後は「あああああ(20/20)」の12字になり、いちばん長いものも12字でした。番号のない部分の字数は、最後の番号の長さに合わせています。そのため「(1/20)」のように桁が少ない番号の1個目は、上限より1字短い11字になります。
上限が短く、文章が長いときは、番号だけで上限に収まらなくなります。10字までで5,000字を分ける場合、番号を「(1/1)」の5字とみて5字ずつに分けると1,000個になります。「(1000/1000)」は11字なので、10字を超えます。そこで、番号のぶんを引いた字数が1字未満になったら、空の配列を返して止めています。10字までで900字なら900個に分かれ、5,000字と10万字では空の配列がすぐに返りました。画面では「字数が少なすぎて、番号を付けると分けられません」と出しています。
入力欄とコピーボタンを付ける
import { useId, useState } from 'react';
import { countChars, splitText, splitWithNumbers, type SplitMode } from './splitText';

export function TextSplitter({ initial = '' }: { initial?: string }) {
  const id = useId();
  const [text, setText] = useState(initial);
  // 入力中の「」(空)も受け付けるため、入力欄の文字列のまま持つ
  const [maxInput, setMaxInput] = useState('140');
  const [mode, setMode] = useState<SplitMode>('sentence');
  const [numbered, setNumbered] = useState(false);
  // 最後にコピーした「何番目の、どの文字列か」
  const [copied, setCopied] = useState<{ index: number; text: string } | null>(null);

  const max = Math.max(10, Math.floor(Number(maxInput)) || 10);
  // 分けた結果は state に持たず、描くたびに作る
  const chunks = numbered ? splitWithNumbers(text, max, mode) : splitText(text, max, mode);

  async function copy(index: number) {
    await navigator.clipboard.writeText(chunks[index]);
    setCopied({ index, text: chunks[index] });
  }

  return (
    <div className="splitter">
      <label htmlFor={`${id}-text`}>文章</label>
      <textarea id={`${id}-text`} rows={6} value={text} onChange={(e) => setText(e.target.value)} />
      <div className="options">
        <label>
          1つあたり
          <input type="number" min={10} value={maxInput} onChange={(e) => setMaxInput(e.target.value)} />
          字まで
        </label>
        <label>
          <input
            type="checkbox"
            checked={mode === 'sentence'}
            onChange={(e) => setMode(e.target.checked ? 'sentence' : 'chars')}
          />
          文の切れ目で分ける
        </label>
        <label>
          <input type="checkbox" checked={numbered} onChange={(e) => setNumbered(e.target.checked)} />
          番号を付ける
        </label>
      </div>
      <p aria-live="polite">
        {text && chunks.length === 0 ? '字数が少なすぎて、番号を付けると分けられません' : `${chunks.length}個に分けました`}
      </p>
      <ol className="chunks">
        {chunks.map((chunk, i) => (
          <li key={i}>
            <p className="chunk-text">{chunk}</p>
            <div className="chunk-footer">
              <span>{countChars(chunk)}字</span>
              <button type="button" onClick={() => copy(i)}>
                {copied?.index === i && copied.text === chunk ? 'コピーしました' : 'コピー'}
              </button>
            </div>
          </li>
        ))}
      </ol>
    </div>
  );
}.splitter {
display: grid;
gap: 8px;
max-width: 560px;
}
.splitter textarea {
font: inherit;
}
.splitter .options {
display: flex;
flex-wrap: wrap;
gap: 8px 16px;
}
.splitter input[type='number'] {
inline-size: 5em;
margin: 0 4px;
}
.chunks {
display: grid;
gap: 8px;
margin: 0;
padding: 0;
list-style: none;
}
.chunks li {
padding: 8px 12px;
border: 1px solid #00c8e8;
border-radius: 6px;
background: #eefafd;
}
.chunk-text {
margin: 0;
/* 改行をそのまま見せ、長い英数字は枠の中で折り返す */
white-space: pre-wrap;
overflow-wrap: anywhere;
}
.chunk-footer {
display: flex;
justify-content: space-between;
align-items: center;
margin-top: 4px;
font-size: 0.85em;
color: #067a98;
}state に持つのは、入力欄の文章、字数の入力欄の文字列、分け方、番号を付けるかどうか、最後にコピーしたものの5つです。分けた結果は state に持たず、描くたびに文章から作ります。
字数の入力欄は、文字列のまま持つ
字数の入力欄は、打った文字列を maxInput にそのまま持ち、分けるときに使う max を、そこから毎回求めています。入力欄に出すのは打った文字列のままなので、打ち直す途中で入力欄が空になっても、入力欄は空のままで、分ける字数だけが下限の10字になります。
Playwright で入力欄を空にしたところ、入力欄は空のまま、分ける字数は下限の10字になり、表示は「11個に分けました」になりました。続けて「4」「0」と打つと、40字までで分けた4個になりました。
「コピーしました」は、番号と中身の両方で決める
コピーには navigator.clipboard.writeText() を使いました。MDN によると、クリップボードへの書き込みは、保護されたコンテキスト(セキュアコンテキスト)でしかできません。HTTPS で配信したページや、http://127.0.0.1、http://localhost のようにローカルで配信したページがこれに当たります。検証では http://127.0.0.1:8080/ で開き、Playwright でクリップボードの権限を与えてから押しました。2個目のボタンを押したあとクリップボードを読むと、「分けた作業は、一つずつ終わらせます。(2/4)」が入っていました。
「コピーしました」を出すかどうかは、copied の番号と文字列の両方が、いまの chunks と合うかで決めています。分け方を変えると、同じ2個目でも中身が変わるからです。「文の切れ目で分ける」を外すと2個目の中身が変わり、どのボタンも「コピー」に戻りました。もう一度「文の切れ目で分ける」を付けると、2個目はコピーしたときと同じ文字列に戻り、そのボタンだけが「コピーしました」になりました。
つなげると、元の文章に戻る
番号を付けないときは、分けたものをそのままつなげると元の文章に戻るように作っています。\r\n を \n にそろえることを除けば、分けるときに文字を足したり削ったりしないので、空白も残ります。半角の空白、絵文字、英文、改行を含む2,250字の文章を、10字、37字、140字までで、文字数ちょうどと文の切れ目の両方で分けたところ、6とおりとも join('') した結果が元の文章と同じになり、どれも上限の字数を超えていませんでした。\r\n を含む 'あい\r\nう' では、\r がなくなるので、つなげても元の文章とは同じになりませんでした。