
ReactでShift_JISのファイルを文字化けせずに読む方法
Shift_JIS のファイルを file.text() で読むと文字化けするのは、このメソッドが中身をいつも UTF-8 として読むからです。ファイルをバイトのまま受け取り、TextDecoder に 'shift_jis' を渡して文字列にすれば、正しく表示できます。バイト列を state に持っておくと、ファイルを選び直さずに文字コードだけを切り替えられます。
検証環境は Ubuntu 24.04、Node.js 22.23.4、Chromium 153 です。使ったのは React 19.3.1、TypeScript 7.0.2、esbuild 0.28.2、Playwright 1.63.0 です。試すファイルは、UTF-8 で書いたテキストを iconv(glibc 2.39)で CP932 に変換して作りました。.tsx を tsc で型チェックしてから esbuild で本番用にビルドし、Playwright でファイルを選んで表示を確かめています。Firefox、Safari、スマートフォンのブラウザ、EUC-JP や ISO-2022-JP のファイル、大きなファイルは試していません。
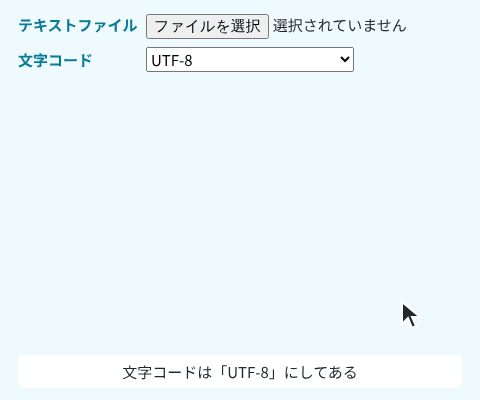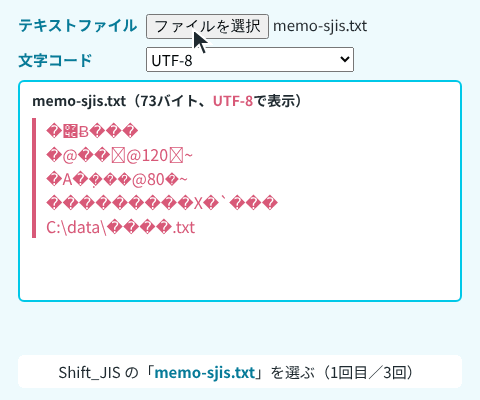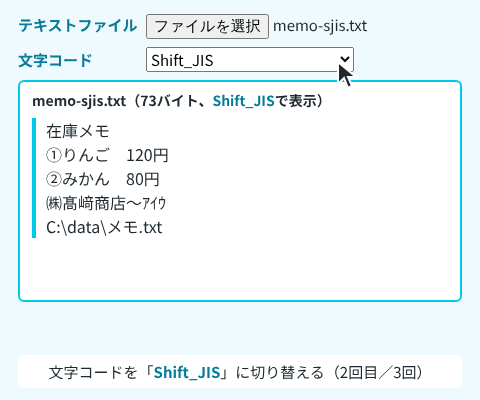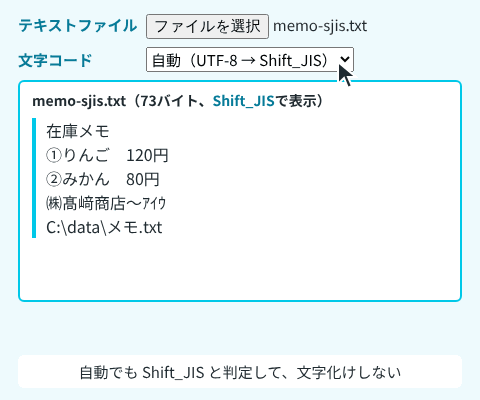
file.text() は、中身をいつも UTF-8 として読む
MDN の Blob.text() の説明には、中身はいつも UTF-8 として扱われると書かれています。引数で文字コードを指定することもできません。
検証用の memo-sjis.txt は、次の5行を iconv で CP932 に変換して保存した、73バイトのファイルです。
在庫メモ
①りんご 120円
②みかん 80円
㈱髙﨑商店〜アイウ
C:\data\メモ.txt
これを Chromium で選び、file.text() で読んだ結果は次のとおりです。
�Ƀ���
�@��@120�~
�A�݂���@80�~
���������X�`���
C:\data\����.txtUTF-8 として読めないバイトが、置換文字の「�」に変わっています。ASCII の範囲の文字(120 や C:\data\)は、このファイルでも UTF-8 と同じ1バイトで書かれているので、そのまま読めています。
TextDecoder に 'shift_jis' を渡して読む
文字コードを指定して読むには、ファイルを arrayBuffer() でバイトのまま受け取り、TextDecoder で文字列にします。
const bytes = await file.arrayBuffer();
const text = new TextDecoder('shift_jis').decode(bytes);
古くからある FileReader.readAsText() でも、2つめの引数に文字コードを渡せます。readAsText(file, 'shift_jis') で読んだ結果は、TextDecoder と同じく正しい文字列でした。
TextDecoder に渡す名前(ラベル)は、WHATWG の Encoding Standard にあるラベルの一覧で決まっています。Shift_JIS のラベルは shift_jis、sjis、windows-31j、ms932 など8つで、どれを渡しても同じ Shift_JIS のデコーダーになります。検証環境の Chromium で試すと、次のようになりました。
shift_jis → shift_jis
Shift_JIS → shift_jis
sjis → shift_jis
shift-jis → shift_jis
windows-31j → shift_jis
ms932 → shift_jis
cp932 → RangeError
x-sjis → shift_jis
ms_kanji → shift_jis
csshiftjis → shift_jis
右側は、作った TextDecoder の encoding の値です。大文字と小文字は区別されません。cp932 は一覧にないため、RangeError になりました。
バイト列を持っておき、文字コードを選び直せるようにする
選ばれたファイルが Shift_JIS か UTF-8 かは、読んでみるまで分かりません。そこで、ファイルを選んだらバイト列を state に入れ、文字列にする処理は文字コードを変えるたびに行う形にします。文字コードを変えても、ファイルを読み直す必要はありません。
文字列にする部分は、React から切り離した関数にしておきます。
export type Choice = 'auto' | 'utf-8' | 'shift_jis';

export type Decoded = { text: string; encoding: 'UTF-8' | 'Shift_JIS' };

export function decodeBytes(bytes: Uint8Array, choice: Choice): Decoded {
  if (choice === 'utf-8') return { text: new TextDecoder('utf-8').decode(bytes), encoding: 'UTF-8' };
  if (choice === 'shift_jis') return { text: new TextDecoder('shift_jis').decode(bytes), encoding: 'Shift_JIS' };
  // 自動:UTF-8 として読めなければ(fatal で TypeError になれば)Shift_JIS で読む
  try {
    return { text: new TextDecoder('utf-8', { fatal: true }).decode(bytes), encoding: 'UTF-8' };
  } catch {
    return { text: new TextDecoder('shift_jis').decode(bytes), encoding: 'Shift_JIS' };
  }
}「自動」では、fatal: true を付けた UTF-8 の TextDecoder で読んでみます。MDN の TextDecoder() の説明のとおり、fatal が false(既定)だと、読めないバイトは置換文字に変わるだけでエラーになりません。true にすると TypeError が投げられます。検証環境でも、memo-sjis.txt を読ませると TypeError になりました。そのときだけ Shift_JIS で読み直します。
コンポーネントは次のとおりです。
import { useId, useMemo, useState } from 'react';
import { decodeBytes, type Choice } from './decode';

type Loaded = { name: string; bytes: Uint8Array };

export function TextFileViewer() {
  const [loaded, setLoaded] = useState<Loaded | null>(null);
  const [choice, setChoice] = useState<Choice>('auto');
  const fileId = useId();
  const choiceId = useId();

  // バイト列はそのまま持っておき、文字コードを変えたら読み直す
  const decoded = useMemo(() => (loaded ? decodeBytes(loaded.bytes, choice) : null), [loaded, choice]);

  async function handleChange(e: React.ChangeEvent<HTMLInputElement>) {
    const file = e.target.files?.[0];
    if (!file) return;
    const bytes = new Uint8Array(await file.arrayBuffer());
    setLoaded({ name: file.name, bytes });
  }

  return (
    <div className="viewer">
      <p>
        <label htmlFor={fileId}>テキストファイル</label>
        <input id={fileId} type="file" accept=".txt,.csv,text/plain,text/csv" onChange={handleChange} />
      </p>
      <p>
        <label htmlFor={choiceId}>文字コード</label>
        <select id={choiceId} value={choice} onChange={(e) => setChoice(e.target.value as Choice)}>
          <option value="auto">自動(UTF-8 → Shift_JIS)</option>
          <option value="utf-8">UTF-8</option>
          <option value="shift_jis">Shift_JIS</option>
        </select>
      </p>
      {loaded && decoded && (
        <section aria-live="polite">
          <p className="name">
            {loaded.name}({loaded.bytes.length}バイト、<span className="encoding">{decoded.encoding}</span>で表示)
          </p>
          <pre className="text">{decoded.text}</pre>
        </section>
      )}
    </div>
  );
}
state に持つのは、読み込んだファイルの名前とバイト列(loaded)と、選んだ文字コード(choice)の2つです。表示する文字列は、この2つから useMemo で作ります。<select> を切り替えると choice だけが変わり、手元のバイト列をもう一度 decodeBytes() に渡します。
検証環境で、ファイルと文字コードの組み合わせを変えて表示を確かめました。Shift_JIS のファイルは、「自動」と「Shift_JIS」では正しく表示され、「UTF-8」では file.text() と同じ文字化けになりました。UTF-8 で保存した memo-utf8.txt(103バイト)は、「自動」では UTF-8 と判定されて正しく表示されました。
逆に、UTF-8 のファイルを「Shift_JIS」で読むと、次のように別の形で文字化けします。
蝨ィ蠎ォ繝。繝「
竭�繧翫s縺斐120蜀�
竭。縺ソ縺九s縲80蜀�
繹ア鬮呻ィ大膚蠎励懶スア�イ�ウ
C:\data\繝。繝「.txt
UTF-8 のファイルでも、Shift_JIS で読むと漢字や半角カナになってしまう部分が多く、「�」が出ない行もあります。自動の判定で UTF-8 から先に試すのは、このためです。
自動の判定で分かるのは「UTF-8 として正しいかどうか」だけです。この関数は、UTF-8 として読めないファイルをすべて Shift_JIS として扱います。ほかの文字コードのファイルは、この部品ではどちらを選んでも正しく表示できません。
①や髙は読めて、〜は全角のチルダになる
①や㈱のような記号や、髙・﨑のような漢字は、検証環境の iconv では SHIFT_JIS へは変換できず、CP932 へは変換できました。
①  SHIFT_JIS: NG  CP932: 87 40
㈱  SHIFT_JIS: NG  CP932: 87 8a
髙  SHIFT_JIS: NG  CP932: fb fc
﨑  SHIFT_JIS: NG  CP932: fa b1
〜  SHIFT_JIS: 81 60  CP932: 81 60
~  SHIFT_JIS: NG  CP932: 81 60
ア  SHIFT_JIS: b1  CP932: b1
ブラウザの TextDecoder('shift_jis') は、CP932 で書き出したこれらの文字も読めます。Shift_JIS のデコーダーが使う Encoding Standard の jis0208 の表には、①(1128番)のような文字も入っています。検証環境では、①は U+2460、㈱は U+3231、髙は U+9AD9、﨑は U+FA11、半角の「ア」は U+FF71 として読めました。
気をつけたいのは「〜」です。元の UTF-8 のテキストには、波ダッシュ(U+301C)の「〜」を書いていましたが、Shift_JIS のファイルから読み直した文字列には、全角のチルダ(U+FF5E)の「~」が入っていました。上の表のとおり、CP932 ではどちらも 81 60 の同じバイトになります。Shift_JIS のデコーダーは、81 60 を jis0208 の表の32番として引きます。表の32番は U+FF5E です。そのため、読み込んだ文字列をコードに書いた '〜'(U+301C)と比べても一致せず、検索しても見つかりません。
ファイルの最後の行にある \(5c のバイト)は、Encoding Standard の Shift_JIS のデコーダーでは ASCII の範囲のバイトとしてそのまま扱われ、検証環境でも U+005C のバックスラッシュになりました。