
Reactで、ふりがな付きの文章を表示する方法
ふりがな付きの文章は、HTML の <ruby> 要素で書けます。React では、{紫陽花|あじさい} のような書き方の文字列を区切りごとに分け、<ruby> と <rt> の JSX を組み立てるコンポーネントを1つ作っておくと、文章のデータにふりがなを書き込むだけで表示できます。
あわせて、ふりがなを消すチェックボックスを作り、ふりがなを付けたときの行間と、文章をコピーしたときにふりがなが混ざる問題を、検証環境で確かめた結果とともに書きます。
検証環境は Ubuntu 24.04、Node.js 22.23.4、Chromium 153 です。使ったのは React 19.3.1、TypeScript 7.0.2、esbuild 0.28.2、Playwright 1.63.0 です。.tsx を tsc で型チェックしてから esbuild で変換し、本番ビルドを Playwright で操作しました。StrictMode を付けた開発ビルドでも同じページを開き、React のエラーや警告が出ないことを確かめています。Firefox と Safari、スマートフォンのブラウザー、縦書き、スクリーンリーダーでの読み上げ、Next.js などのサーバーで描画するフレームワークの上での動きは試していません。
ruby 要素の形
ふりがなを付けた HTML は次の形です。<rt> の中がふりがなで、<rt> の前に書いた文字(ここでは「紫陽花」)の上に出ます。
<ruby>紫陽花<rp>(</rp><rt>あじさい</rt><rp>)</rp></ruby><rp> は、ルビの表示に対応していないブラウザーのための括弧です。MDN の rp 要素のページには、対応していないブラウザーでは「漢 (Kan) 字 (ji)」のように括弧付きで見える例が載っています。検証環境の Chromium では、<rp> の display は none で、画面には出ませんでした。
1つの <ruby> の中に、文字とふりがなの組を続けて書くこともできます。ruby 要素のページには、「漢」と「字」に1文字ずつふりがなを付ける例が載っています。
ふりがなの書き方を決めて、文字列を分ける
文章のデータには、{漢字|よみ} の形でふりがなを書くことにします。熟語の1文字ずつに付けたいときは、{写真|しゃ|しん} のように読みを | で区切って並べます。
この文字列を、ふつうの文字の部分とふりがなを付ける部分に分ける関数です。
export type RubyPair = { base: string; reading: string };

export type Segment =
  | { type: 'text'; text: string }
  | { type: 'ruby'; pairs: RubyPair[] };

// {東京|とうきょう}   → 「東京」全体に「とうきょう」
// {東京|とう|きょう} → 「東」に「とう」、「京」に「きょう」
const RUBY = /\{([^{}|]+)((?:\|[^{}|]+)+)\}/g;

export function parseRuby(source: string): Segment[] {
  const segments: Segment[] = [];
  let last = 0;
  for (const m of source.matchAll(RUBY)) {
    if (m.index > last) segments.push({ type: 'text', text: source.slice(last, m.index) });
    const base = m[1];
    const readings = m[2].slice(1).split('|');
    const chars = Array.from(base);
    if (readings.length === 1) {
      segments.push({ type: 'ruby', pairs: [{ base, reading: readings[0] }] });
    } else if (readings.length === chars.length) {
      segments.push({ type: 'ruby', pairs: chars.map((c, i) => ({ base: c, reading: readings[i] })) });
    } else {
      // 読みの数と文字の数が合わないときは、書いたままの文字を出す
      segments.push({ type: 'text', text: m[0] });
    }
    last = m.index + m[0].length;
  }
  if (last < source.length) segments.push({ type: 'text', text: source.slice(last) });
  return segments;
}文字を1つずつに分けるときは、base.split('') ではなく Array.from(base) を使っています。split('') では、「𠮷」のような一部の文字が2つに割れてしまいます。検証環境では、'𠮷野'.split('') の長さは3、Array.from('𠮷野') の長さは2でした。{𠮷野|よし|の} は、「𠮷」に「よし」、「野」に「の」が付きました。
分けた結果から ruby 要素を組み立てる
分けた結果を JSX にするコンポーネントです。
import { Fragment } from 'react';
import { parseRuby } from './parseRuby';

export function RubyText({ children }: { children: string }) {
  return (
    <>
      {parseRuby(children).map((seg, i) =>
        seg.type === 'text' ? (
          <Fragment key={i}>{seg.text}</Fragment>
        ) : (
          <ruby key={i}>
            {seg.pairs.map((p, j) => (
              <Fragment key={j}>
                {p.base}
                <rp>(</rp>
                <rt>{p.reading}</rt>
                <rp>)</rp>
              </Fragment>
            ))}
          </ruby>
        ),
      )}
    </>
  );
}
1組ぶんの「文字・括弧・ふりがな・括弧」は、余計な要素を増やさないように Fragment でまとめています。<>...</> の短い書き方では key を渡せないので、React 公式ドキュメントのリストのレンダーのページにあるとおり <Fragment key={...}> と書きます。key には配列の位置を使いました。同じページには、項目の挿入・削除や並べ替えがあると、位置を key にした書き方はバグの原因になるとあります。一方で、同じページのチャレンジ問題では、俳句の行は入れ替わらないので、特例として位置を key にしてよいとしています。ここで並べている区切りも、同じ文字列からは毎回同じ順番で作られ、入れ替わりません。そのため、ここでは位置を key にしています。
Node.js で renderToStaticMarkup を使い、いくつかの文字列で出力を確かめました。
| 入力 | 出力される HTML |
|---|---|
{東京|とうきょう}へ行く |
<ruby>東京<rp>(</rp><rt>とうきょう</rt><rp>)</rp></ruby>へ行く |
{東京|とう|きょう}へ行く |
<ruby>東<rp>(</rp><rt>とう</rt><rp>)</rp>京<rp>(</rp><rt>きょう</rt><rp>)</rp></ruby>へ行く |
{東京|と|う|きょう}へ行く |
{東京|と|う|きょう}へ行く(読みが3つで文字が2つなので、そのまま) |
{猫|}と{|ねこ} |
{猫|}と{|ねこ}(漢字か読みが空なので、そのまま) |
<b>{猫|ねこ}</b> |
<b><ruby>猫<rp>(</rp><rt>ねこ</rt><rp>)</rp></ruby></b> |
最後の行のように、文字列の中に HTML のタグを書いても、タグとしては扱われませんでした。<b> とエスケープされて、ただの文字として出力されています。
画面に出すときは、文章を RubyText の子に渡します。
const TEXT = '{雨|あめ}の{日|ひ}に{紫陽花|あじさい}の{写真|しゃ|しん}を{撮|と}りました。';

<p className="text">
  <RubyText>{TEXT}</RubyText>
</p>
検証環境の Chromium(文字の大きさ 20px)では、ふりがなは 10px で表示されました。「紫陽花」の文字の上端が 65px、ふりがなの下端が 65px で、ふりがなは漢字のすぐ上にあり、左右の中心も漢字とそろっていました。
ふりがなを付けるなら、行の高さに余裕を取る
ふりがなは、漢字の上の、行と行のあいだの空きに出ます。そのため、行の高さ(line-height)しだいで、ふりがなの付いた行だけ高さが変わったり、上の行の文字にふりがなが近づいたりします。
幅 200px で2行になる段落を作り、2行目の漢字にだけふりがなを付けて比べました。文字の大きさは 20px です。
| line-height | ふりがななしの段落の高さ | ふりがなありの段落の高さ | 1行目の文字の下端と、ふりがなの上端の間 |
|---|---|---|---|
| normal | 40px | 50px | 0px |
| 1.5 | 60px | 60px | 0px |
| 2 | 80px | 80px | 10px |
normal では、ふりがなの入る空きがなく、ふりがなの付いた行だけが 10px 高くなりました。行の間隔がそろわなくなります。1.5 では段落の高さは変わりませんでしたが、ふりがなが上の行の文字にくっつきました。2 にすると、高さは変わらず、上の行との間に 10px の空きが残りました。この記事の CSS では、ふりがなを付ける段落を line-height: 2 にしています。
チェックボックスで、ふりがなを消す
ふりがなを消すときは、段落にクラスを付けて、CSS で <rt> を見えなくします。
import { useState } from 'react';
import { RubyText } from './RubyText';

const TEXT = '{雨|あめ}の{日|ひ}に{紫陽花|あじさい}の{写真|しゃ|しん}を{撮|と}りました。';

export function App() {
  const [showRuby, setShowRuby] = useState(true);
  return (
    <main>
      <label className="ruby-toggle">
        <input type="checkbox" checked={showRuby} onChange={(e) => setShowRuby(e.target.checked)} />
        ふりがなを表示する
      </label>
      <p className={showRuby ? 'text' : 'text ruby-off'}>
        <RubyText>{TEXT}</RubyText>
      </p>
    </main>
  );
}.text { font-size: 20px; line-height: 2; }
/* ふりがなを消しても、文字の位置は変えない */
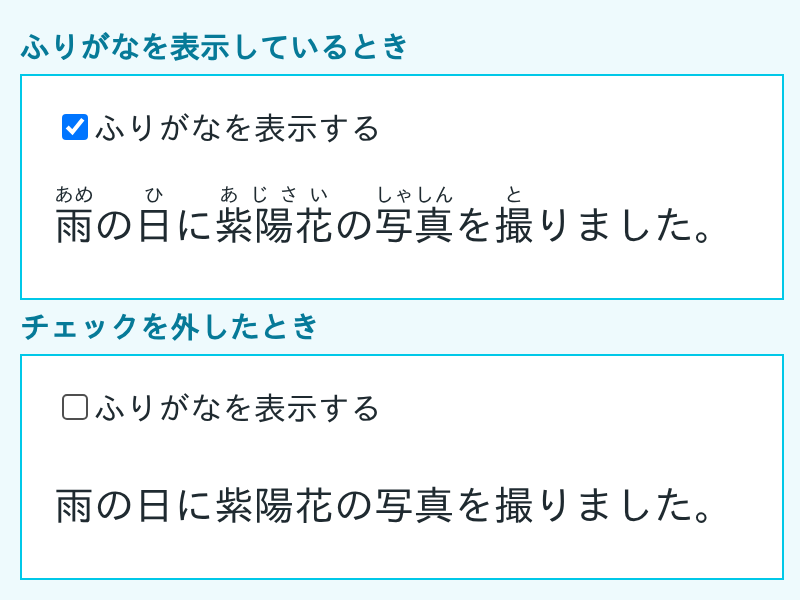
.ruby-off rt { visibility: hidden; }検証環境でチェックボックスをクリックすると、段落に ruby-off が付き、<rt> の visibility は hidden になりました。チェックボックスにフォーカスがある状態で、もう一度 Space キーを押すと visible に戻りました。段落の高さは、どちらの状態でも 40px のままです。冒頭の画像のとおり、ふりがなが消えても文章の位置は動きません。
display: none ではなく visibility: hidden にしたのは、ふりがなが漢字より長いときに文字の位置がずれないようにするためです。<ruby>承<rt>うけたまわ</rt></ruby>る で、「る」の左端の位置を測りました。
| ふりがなの状態 | 「る」の左端 |
|---|---|
| 表示している | 45px |
visibility: hidden で消した |
45px |
display: none で消した |
20px |
display: none では、ふりがなの幅がなくなって「る」が左に寄りました。切り替えのたびに文章が左右に動きます。MDN の visibility のページにあるとおり、hidden は描画しないだけで、レイアウトには通常どおり影響します。同じページには、hidden にした要素はアクセシビリティツリーから外れ、読み上げ技術で読まれなくなるとも書かれています。
コピーしたとき、ふりがなが文章に混ざる
ふりがなを表示したまま段落を選択してコピーすると、ふりがなも一緒にコピーされます。検証環境で、段落全体を選択して document.execCommand('copy') でコピーし、クリップボードの中身を読みました。
| CSS | クリップボードの中身 |
|---|---|
| 何も足さない | 雨あめの日ひに紫陽花あじさいの写しゃ真しんを撮とりました。 |
rt, rp { user-select: none; } |
雨の日に紫陽花の写真を撮りました。 |
.ruby-off rt { visibility: hidden; }(ふりがなを消した状態) |
雨の日に紫陽花の写真を撮りました。 |
.text rt { display: none; } |
雨の日に紫陽花の写真を撮りました。 |
何もしないと、漢字のすぐ後ろにふりがなが続いた文字列になりました。<rp> の括弧は入りません。ふりがなを表示したまま本文だけをコピーさせたいなら、<rt> と <rp> に user-select: none を付けます。MDN によると、none を付けた要素の文章は範囲選択できなくなります。
rt, rp { user-select: none; }JavaScript で文字を取り出すときも、ふりがなは混ざります。段落の textContent は「雨(あめ)の日(ひ)に紫陽花(あじさい)の写(しゃ)真(しん)を撮(と)りました。」で、<rp> の括弧も入っていました。Playwright の getByText('雨の日に') で段落を探しても、見つかった要素は0件でした。