
Reactで、1文の長さを数えて長い文を目立たせる方法
文章を句点で1文ずつに分け、文ごとに文字数を数えて、決めた文字数を超える文だけを <mark> で囲んで表示します。React で持つ state は、文章と上限の文字数の2つだけです。文の区切りと文字数は、レンダーのたびに文章から計算し直します。
文の区切りには Intl.Segmenter の sentence も使えます。ただ、日本語のかぎかっこを含む文では、区切りが思わぬ位置に入りました。そこで、句点とかっこを見て自分で区切る関数を書き、Intl.Segmenter の結果と並べて比べています。
検証環境は Ubuntu 24.04、Node.js 22.23.4(ICU 78.3)、Chromium 153 です。使ったのは React 19.3.1、TypeScript 7.0.2、esbuild 0.28.2、Playwright 1.63.0 です。.tsx を tsc で型チェックしてから esbuild で本番用にビルドし、Playwright で入力欄を操作して確かめました。Firefox、Safari、スマートフォンのブラウザ、日本語入力(IME)での入力、スクリーンリーダーでの読み上げは試していません。テキストエリアの中の文字に直接色を付ける方法も扱っていません。
Intl.Segmenter で文に分けると、かぎかっこで区切りがずれる
Intl.Segmenter は、granularity に "sentence" を渡すと、文字列を文の区切りで分けます(MDN の Intl.Segmenter() コンストラクターのページ)。ふつうの文なら、句点ごとにきれいに分かれました。
入力    "今日は晴れです。明日は雨です。"
  Intl.Segmenter ["今日は晴れです。","明日は雨です。"]
ところが、かぎかっこの中に句点がある文では、区切りが思わぬ位置に入りました。
入力    "「行こう。」と彼は言った。次の文です。"
  Intl.Segmenter ["「行こう。」","と彼は言った。","次の文です。"]
入力    "「はい。」「いいえ。」"
  Intl.Segmenter ["「はい。」「","いいえ。」"]
1つ目は、「と彼は言った。」が独立した文になり、1文の長さとしては短く数えられます。2つ目は、2つ目のかぎかっこの「「」が、前の文の終わりに付いてしまいました。
Node.js が使っている ICU の文の区切りの規則では、文の終わりの記号のあとに、かっこの文字と空白が0個以上続いたところで区切ります。ここでいうかっこの文字は、Unicode の文の区切りの分類で Close に当たる文字です。Unicode 17.0 の分類の表では、「」」だけでなく、開きかっこの「「」も Close に入っています。
そのため、「行こう。」の「。」のあとの「」」までで文が終わり、「と彼は言った。」が次の文になります。2つ目の例で「「」が前の文に付いたのも、「。」「」」のあとに続く「「」が同じ Close だからです。かぎかっこのあとに「と」などが続く文は1文として数えたいので、長い文を探す用途には、Intl.Segmenter の区切りはそのままでは使えません。
句点とかっこを見て、自分で文に分ける
そこで、次の決まりで区切る関数 splitSentences() を書きました。
- 「。」「.」「!」「?」(半角の
!?も)のあとで区切る。「?!」のように続いたときは、まとめて1つの終わりにする。 - かっこ(「」『』()など)の中にある句点では区切らない。
- 改行のところでも区切る。閉じ忘れたかっこは、改行のところで打ち切る。
- 「はい。」「いいえ。」のように、句点で終わったかっこのすぐあとに、開きかっこが続くときは、その間で区切る。
文字数は、見た目の1文字ごとに数えます。Intl.Segmenter の grapheme で数えると、"🐈⬛".length が 4 になる絵文字も1文字になります。文の前後の空白と改行は、文字数に入れません。
export type Sentence = { text: string; start: number; length: number };

const ENDS = new Set(['。', '.', '!', '?', '!', '?']);
const OPEN = new Set(['「', '『', '(', '(', '【', '〈', '《']);
const CLOSE = new Set(['」', '』', ')', ')', '】', '〉', '》']);

const graphemes = new Intl.Segmenter('ja', { granularity: 'grapheme' });

// 見た目の1文字ごとに数える。文の前後の空白と改行は数えない
export function countChars(text: string): number {
  let n = 0;
  for (const _ of graphemes.segment(text.trim())) n++;
  return n;
}

// 。!?と改行で文を区切る。かっこの中の。では区切らない
export function splitSentences(text: string): Sentence[] {
  const result: Sentence[] = [];
  let start = 0;
  let depth = 0;

  const cut = (end: number, takeSpaces = true) => {
    // 句点などのあとの空白は、前の文に含める(改行のあとの字下げは次の文に残す)
    while (takeSpaces && (text[end] === ' ' || text[end] === ' ')) end++;
    const s = text.slice(start, end);
    if (s.trim() === '') {
      // 空白や改行だけなら文にしない。前の文があれば、その後ろに付ける
      const last = result.at(-1);
      if (last) {
        last.text += s;
        start = end;
      }
      return end;
    }
    result.push({ text: s, start, length: countChars(s) });
    start = end;
    return end;
  };

  for (let i = 0; i < text.length; i++) {
    const c = text[i];
    if (c === '\n') {
      depth = 0; // 閉じ忘れたかっこは、段落の終わりで打ち切る
      i = cut(i + 1, false) - 1;
    } else if (OPEN.has(c)) {
      depth++;
    } else if (CLOSE.has(c)) {
      if (depth > 0) depth--;
      // 「はい。」「いいえ。」のように、文で終わるかっこが続くときは区切る
      if (depth === 0 && ENDS.has(text[i - 1]) && OPEN.has(text[i + 1])) i = cut(i + 1) - 1;
    } else if (depth === 0 && ENDS.has(c)) {
      while (ENDS.has(text[i + 1])) i++; // ?! のように続く記号は1つにまとめる
      i = cut(i + 1) - 1;
    }
  }
  cut(text.length);
  return result;
}
区切った文の text には、文のあとの空白や改行も含めています。全部の text をつなぐと、元の文章に戻ります。表示するときに文と文の間の文字が消えないようにするためです。検証で試したどの文章でも、つないだ結果は元の文章と同じでした。
Intl.Segmenter と並べた結果は、次のとおりです。数字は、splitSentences() が数えた文ごとの文字数です。
入力 "「行こう。」と彼は言った。次の文です。"
Intl.Segmenter ["「行こう。」","と彼は言った。","次の文です。"]
splitSentences ["「行こう。」と彼は言った。","次の文です。"] 13,6
入力 "「はい。」「いいえ。」"
Intl.Segmenter ["「はい。」「","いいえ。」"]
splitSentences ["「はい。」","「いいえ。」"] 5,6
入力 "1つ目の段落です。\n\n2つ目の段落です。"
Intl.Segmenter ["1つ目の段落です。\n","\n","2つ目の段落です。"]
splitSentences ["1つ目の段落です。\n\n","2つ目の段落です。"] 9,9
入力 "猫の絵文字🐈⬛を入れた文です。"
Intl.Segmenter ["猫の絵文字🐈⬛を入れた文です。"]
splitSentences ["猫の絵文字🐈⬛を入れた文です。"] 14Intl.Segmenter では、空行の改行が1つの文として出てきます。splitSentences() では、空白と改行だけの部分を前の文の後ろに付けるので、文の数に入りません。「3.14」のような半角のピリオドは区切りに入れていないので、小数の途中では区切りません。
この決まりでも、うまく区切れない文があります。
入力    "(注:これは補足です。)本文に戻ります。"
  Intl.Segmenter ["(注:これは補足です。)","本文に戻ります。"]
splitSentences ["(注:これは補足です。)本文に戻ります。"] 20かっこの中で文が完結し、かっこのあとに別の文が始まる場合です。「行こう。」と彼は言った。 と同じ形なので、文字だけでは見分けられません。この関数では、この形をいつも1文として数えます。
長い文を mark で囲んで表示する
部品では、文章と上限の文字数を state に持ちます。区切った文と、長い文の数は state にせず、レンダーのたびに計算します。React の公式ドキュメントにある、props や state から計算できるものは state に入れず、レンダー中に計算するという考え方に沿った書き方です。
import { useId, useState } from 'react';
import { splitSentences } from './sentences';

const SAMPLE =
  '文が長くなると、読み手は途中で主語を見失います。' +
  '特にスマートフォンでは一度に見える文字が少ないので、読点で区切りながら続けた長い文は、どこで切れるのかを探しながら読むことになり、内容よりも文の形に気を取られてしまいます。' +
  '「短く書こう。」と決めても、書いている最中は気づきにくいものです。';

export function LongSentenceChecker() {
  const [text, setText] = useState(SAMPLE);
  const [limitText, setLimitText] = useState('60');
  const textId = useId();
  const limitId = useId();

  const sentences = splitSentences(text);
  const limit = Number(limitText);
  const valid = Number.isInteger(limit) && limit > 0;
  const isLong = (length: number) => valid && length > limit;
  const longCount = sentences.filter((s) => isLong(s.length)).length;

  return (
    <div className="checker">
      <label htmlFor={textId}>文章</label>
      <textarea id={textId} rows={6} value={text} onChange={(e) => setText(e.target.value)} />

      <label htmlFor={limitId}>長い文とみなす文字数</label>
      <input
        id={limitId}
        type="number"
        min={1}
        step={10}
        value={limitText}
        onChange={(e) => setLimitText(e.target.value)}
      />
      <span>字を超える文</span>

      <p className="summary">
        {valid
          ? `${sentences.length}文のうち、${limit}字を超える文は${longCount}文です。`
          : '文字数は1以上の整数で入れてください。'}
      </p>

      <p className="preview">
        {sentences.map((s) =>
          isLong(s.length) ? (
            <mark key={s.start}>
              {s.text}
              <small>({s.length}字)</small>
            </mark>
          ) : (
            <span key={s.start}>{s.text}</span>
          ),
        )}
      </p>
    </div>
  );
}
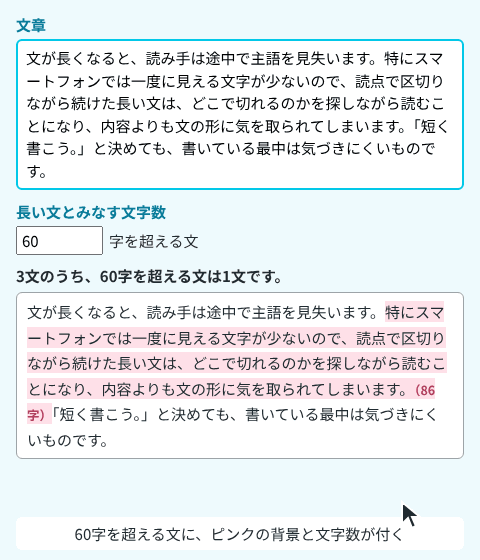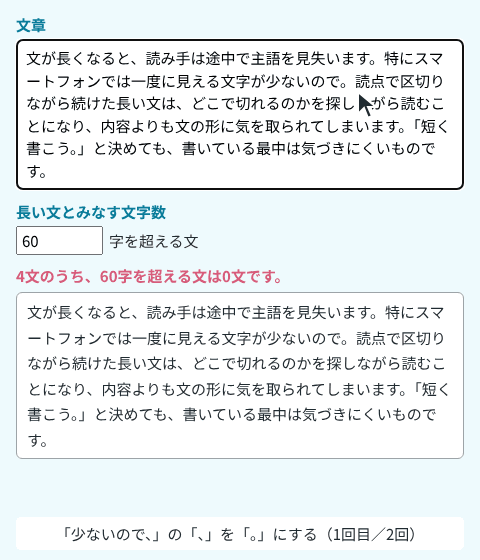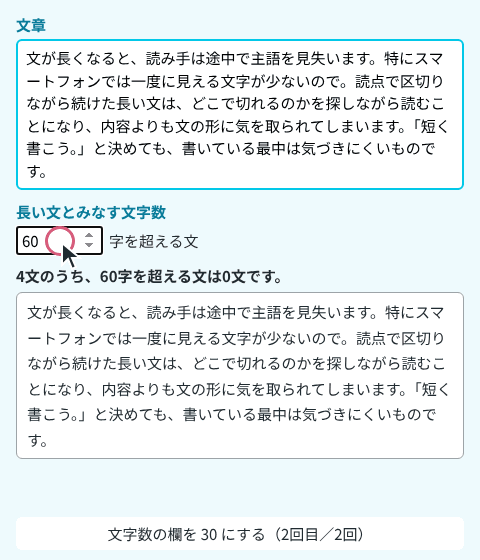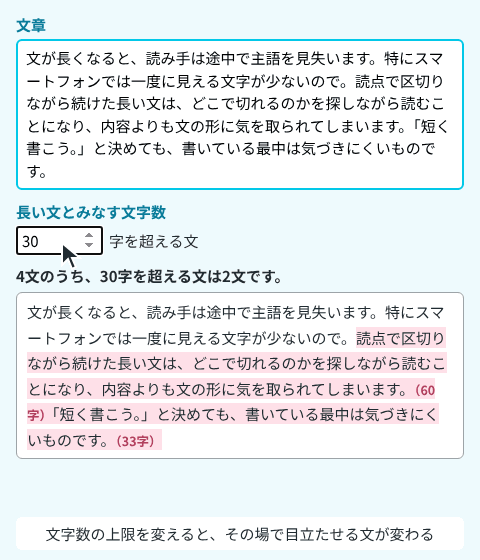
長い文は <mark> で囲み、後ろに「(86字)」のように文字数を添えます。MDN の <mark> のページでは、前後の文脈に関連があることを示すために目立たせた文字を表す要素だと説明されています。色は CSS で、背景を薄いピンクにしました(関係する部分だけを抜き出しています)。
.preview { white-space: pre-wrap; }
mark { background: #ffe1e9; color: inherit; }
mark small { color: #b03a58; font-weight: bold; }
文の text には改行も含まれているので、表示の <p> に white-space: pre-wrap を指定して、入力した改行をそのまま見せます。key には、文が文章の何文字目から始まるか(start)を使いました。1つの文章の中で、2つの文が同じ位置から始まることはないので、重なりません。
上限の文字数は、入力欄の文字列のまま state に持ち、レンダーのときに Number() で数値にします。空欄や、整数でない値、1より小さい値のときは、どの文も目立たせず、「文字数は1以上の整数で入れてください。」と出します。
Chromium で操作したときの表示
Playwright で入力欄を操作し、そのつど要約の文と <mark> の中身を読みました。最初の表示(上限60字)では、86字の文だけが <mark> になりました。
--- 最初の表示(60字)
summary : 3文のうち、60字を超える文は1文です。
mark    : ["特にスマートフォンでは一度に見える文字が少ないので、読点で区切りながら続けた長い文は、どこで切れるのかを探しながら読むことになり、内容よりも文の形に気を取られてしまいます。(86字)"]
上限を100字にすると <mark> はなくなりました。欄を空にしたときと、2.5、0 を入れたときは、要約が「文字数は1以上の整数で入れてください。」に変わり、<mark> も出ませんでした。上限を60字に戻し、改行してから89字の文を書き足すと、その文にも <mark> が付き、要約は「4文のうち、60字を超える文は2文です。」になりました。
文章を次の2行にすると、要約は「3文のうち」になりました。
「はい。」「いいえ。」
「行こう。」と彼は言った。表示された文は、「はい。」、「いいえ。」、「行こう。」と彼は言った。 の3つで、1行目が2文、2行目が1文と数えられています。
上の GIF は、86字の文の「少ないので、」の読点を句点に打ち換えたところです。2つの文に分かれ、後ろの文は60字になりました。60字は「60字を超える」に当たらないので、ピンクの背景が消えました。そのあと上限を30字にすると、60字と33字の文に背景が付きました。
文章が長いときに、区切りにかかる時間
文章を変えるたびに、全部の文を区切り直して数えています。検証環境の Node.js で、同じ段落をくり返した文章を splitSentences() に渡し、3回空回ししてから11回測りました。
10000字(857文)を区切る時間 中央値 9.5ms 最小 8.0ms 最大 11.0ms
100000字(8572文)を区切る時間 中央値 109.0ms 最小 95.3ms 最大 132.2ms
1万字では、1回の区切り直しが中央値で9.5ミリ秒と、10ミリ秒に届きませんでした。10万字では中央値で109.0ミリ秒でした。文字数が10倍で、時間は約11倍です。