
Reactで、ひらがなとカタカナを変換する方法
ひらがなとカタカナは、Unicode では同じ並びで、文字コードがちょうど 0x60 離れています。そのため、「ぁ」から「ゖ」までの文字コードに 0x60 を足せばカタカナに、カタカナから 0x60 を引けばひらがなに変わります。この範囲から外れる「ヷ」や半角カナにだけ、別の処理を足します。
ここでは、変換の関数を kana.ts にまとめ、ボタンで変換する KanaConverter と、欄を離れたときにカタカナにそろえる FuriganaField という2つのコンポーネントを作りました。
検証環境は Ubuntu 24.04、Node.js 22.23.4、Chromium 153 です。使ったのは react / react-dom 19.3.1、@types/react 19.3.0、typescript 7.0.2、esbuild 0.28.2、wanakana 5.3.1、Playwright 1.63.0 です。関数の結果は Node.js で確かめ、tsc で型エラーがないことを確かめました。コンポーネントは StrictMode で包んだ開発用のビルドを、幅 375px の Chromium で Playwright から操作しました。日本語入力(IME)で打ったときの動き、Firefox と Safari、スマートフォンの実機は試していません。
文字コードを 0x60 ずらす関数
変換の関数は次のとおりです。正規表現で変換する文字だけを選び、文字コードをずらします。
// ひらがなとカタカナを、文字コードを 0x60 ずらして変換する

const OFFSET = 0x60;

// ぁ〜ゖ(U+3041〜U+3096)と、繰り返し記号の ゝ ゞ をカタカナにする
export function toKatakana(input: string): string {
  return (
    input
      .replace(/[\u3041-\u3096\u309D\u309E]/g, (c) =>
        String.fromCharCode(c.charCodeAt(0) + OFFSET),
      )
      // 「わ」「ゐ」「ゑ」「を」に濁点(U+3099)が付いていたら、1文字の ヷ ヸ ヹ ヺ にまとめる
      .replace(/([\u30EF-\u30F2])\u3099/g, (_, c: string) =>
        String.fromCharCode(c.charCodeAt(0) + 8),
      )
  );
}

// ァ〜ヶ(U+30A1〜U+30F6)と、繰り返し記号の ヽ ヾ をひらがなにする
export function toHiragana(input: string): string {
  return (
    input
      // ヷ ヸ ヹ ヺ は1文字のひらがながないので、「わ」などと濁点(U+3099)の2文字にする
      .replace(/[\u30F7-\u30FA]/g, (c) =>
        String.fromCharCode(c.charCodeAt(0) - 8 - OFFSET) + '\u3099',
      )
      .replace(/[\u30A1-\u30F6\u30FD\u30FE]/g, (c) =>
        String.fromCharCode(c.charCodeAt(0) - OFFSET),
      )
  );
}

// 半角カナ(U+FF61〜U+FF9F)の部分だけを全角にする。「ガ」は1文字の「ガ」になる
export function halfwidthKanaToFullwidth(input: string): string {
  return input.replace(/[\uFF61-\uFF9F]+/g, (s) => s.normalize('NFKC'));
}

// ひらがなとカタカナの違いを無視して、文字列が含まれるかを調べる
export function includesIgnoringKana(text: string, query: string): boolean {
  const fold = (s: string) => toHiragana(halfwidthKanaToFullwidth(s));
  return fold(text).includes(fold(query));
}
検証環境の Node.js で toKatakana('ねこの てちょう') を実行すると ネコノ テチョウ になりました。小さい「ぁ」「っ」「ゃ」「ゎ」も、小さいカタカナの「ァ」「ッ」「ャ」「ヮ」になります。「ゔ」「ゕ」「ゖ」も、それぞれ「ヴ」「ヵ」「ヶ」に変わりました。
逆に toHiragana('ヴァイオリンと ラーメン') は ゔぁいおりんと らーめん です。長音の「ー」(U+30FC)は変えずに残しています。Unicode での名前が KATAKANA-HIRAGANA PROLONGED SOUND MARK で、ひらがなとカタカナの両方で使う文字だからです。中黒の「・」(U+30FB)も変換の範囲の外なので、そのまま残ります。Tokyo 東京 2026 は、toHiragana() と toKatakana() のどちらに渡しても変わりませんでした。
ぁ〜ゖ、ァ〜ヶの外にある文字
ぁ〜ゖ(U+3041〜U+3096)とァ〜ヶ(U+30A1〜U+30F6)の外にある、かなに関係する文字は、次のように扱いました。
| 文字 | 文字コード | 扱い |
|---|---|---|
| ゝ ゞ / ヽ ヾ | U+309D〜U+309E / U+30FD〜U+30FE | 繰り返し記号。0x60 離れているので、範囲に入れて変換する |
| ヷ ヸ ヹ ヺ | U+30F7〜U+30FA | 1文字のひらがながない。「わ」などと濁点(U+3099)の2文字にする |
| ゟ | U+309F | 「より」を1文字にした字(HIRAGANA DIGRAPH YORI)。そのまま残す |
| ヿ | U+30FF | 「コト」を1文字にした字(KATAKANA DIGRAPH KOTO)。そのまま残す |
| ㇰ ㇱ ㇲ など | U+31F0〜 | 小さいカタカナの追加分(KATAKANA LETTER SMALL KU など)。0x60 ずらす範囲の外なので残す |
| カ ゙ など | U+FF61〜U+FF9F | 半角カナ。先に halfwidthKanaToFullwidth() で全角にする |
「ヷ」(U+30F7)から 0x60 を引くと U+3097 になりますが、ここには文字が割り当てられていません。検証環境の Node.js では /\p{Cn}/u(未割り当ての文字)に一致し、Python の unicodedata でも名前がありませんでした。そこで、「ヷ」は「ワ」に濁点を付けた文字として、「わ」(U+308F)と結合用の濁点(U+3099)の2文字にしています。toKatakana() では、この2文字が並んでいたら1文字の「ヷ」に戻します。検証環境で toKatakana(toHiragana('ヷ')) は ヷ になり、元に戻りました。
toKatakana() で「ワ」と濁点をまとめる処理には、正規表現を使いました。normalize('NFC') でも、検証環境では「ワ」(U+30EF)と濁点(U+3099)の2文字が1文字の「ヷ」(U+30F7)になりました。MDN の normalize() の説明にあるとおり、NFC は分解してから合成し直す形式なので、「ヷ」のように合成済みの文字がある組み合わせは1文字になります。ただし、文字列全体に NFC をかけると、ほかの文字まで変わります。検証環境では、互換用の漢字 U+FA19(CJK COMPATIBILITY IDEOGRAPH-FA19。見た目は「神」)が、ふつうの「神」(U+795E)になりました。そこで、「ワ」「ヰ」「ヱ」「ヲ」と濁点が並んだところだけを置き換えています。
「か」と結合用の濁点(U+3099)の2文字で書かれた「が」は、toKatakana() に渡すと「カ」と濁点の2文字になりました。濁点は範囲の外なので、そのまま残ります。
半角カナは、先に全角にする
toHiragana('ネコ') は ネコ のままです。半角カナは文字コードの並びが全角と違うので、0x60 ずらす方法では変換できません。halfwidthKanaToFullwidth() で半角カナの部分だけに normalize('NFKC') をかけ、全角にしてから変換します。検証環境では、ネコ ガイド ①㈱ が ネコ ガイド ①㈱ になりました。「ガ」の2文字は1文字の「ガ」にまとまり、半角カナの外にある「①」と「㈱」はそのまま残っています。
ボタンで変換する入力欄
KanaConverter は、欄の文字を、ボタンでひらがなかカタカナに変えます。
import { useId, useState } from 'react';
import { toHiragana, toKatakana } from './kana';

export function KanaConverter({ initial = '' }: { initial?: string }) {
  const id = useId();
  const [text, setText] = useState(initial);
  const [message, setMessage] = useState('');

  function convert(to: 'hiragana' | 'katakana') {
    const next = to === 'hiragana' ? toHiragana(text) : toKatakana(text);
    const label = to === 'hiragana' ? 'ひらがな' : 'カタカナ';
    setMessage(next === text ? `${label}にする文字はありませんでした` : `${label}にしました`);
    setText(next);
  }

  return (
    <div className="kana-converter">
      <label htmlFor={`${id}-text`}>変換する文字</label>
      <textarea
        id={`${id}-text`}
        rows={3}
        value={text}
        onChange={(e) => {
          setText(e.target.value);
          setMessage('');
        }}
      />
      <div className="buttons">
        <button type="button" onClick={() => convert('hiragana')}>
          ひらがなにする
        </button>
        <button type="button" onClick={() => convert('katakana')}>
          カタカナにする
        </button>
      </div>
      <p role="status">{message}</p>
    </div>
  );
}.kana-converter, .furigana-field { display: grid; gap: 8px; max-width: 480px; }
.kana-converter textarea, .furigana-field input { font-size: 16px; }
.kana-converter .buttons { display: flex; gap: 8px; }
.kana-converter [role='status'] { margin: 0; min-height: 1.5em; color: #067a98; }変換の前と後の文字列が同じなら、変える文字がなかったと分かります。その場合は「ひらがなにする文字はありませんでした」のように出します。結果のメッセージは role="status" の <p> に出し、欄に何か打ったら消します。
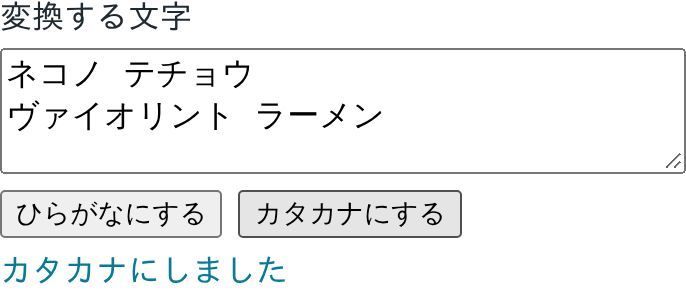
初期値を「ねこの てちょう」「ヴァイオリンと ラーメン」の2行にして、Playwright でボタンを押しました。「ひらがなにする」を押すと2行目が「ゔぁいおりんと らーめん」になり、「ひらがなにしました」と出ました。もう一度押すと、欄は変わらず「ひらがなにする文字はありませんでした」と出ました。続けて「カタカナにする」を押すと、2行は「ネコノ テチョウ」「ヴァイオリント ラーメン」になりました。
関数は文の意味を見ないので、助詞の「の」や「と」もカタカナになります。文章の中の一部の言葉だけを変えたいときは、その部分を選んでから変換する作りにするか、変換したあとに手で直す必要があります。
フリガナの欄を、離れたときにカタカナにそろえる
フリガナの欄は、ひらがなで打っても、送るときには全角カタカナにそろえたいことがあります。FuriganaField では、打っている間は欄の文字を変えず、欄を離れたとき(onBlur)に変換しました。
import { useId, useState } from 'react';
import { halfwidthKanaToFullwidth, toKatakana } from './kana';

// フリガナの欄。打っている間は変えず、欄を離れたときに全角カタカナにそろえる
export function FuriganaField({ name }: { name: string }) {
  const id = useId();
  const [value, setValue] = useState('');

  return (
    <div className="furigana-field">
      <label htmlFor={id}>フリガナ</label>
      <input
        id={id}
        name={name}
        value={value}
        onChange={(e) => setValue(e.target.value)}
        onBlur={() => setValue(toKatakana(halfwidthKanaToFullwidth(value)))}
      />
    </div>
  );
}
この欄を <form> の中に置き、Playwright で「やまだ タロウ」と1文字ずつ打ちました。打った直後の欄は「やまだ タロウ」のままで、Tab キーで欄を離れると「ヤマダ タロウ」になりました。フォームを FormData にして get('kana') で読んだ値も「ヤマダ タロウ」です。半角カナの「タロウ」も、全角のカタカナにそろいました。
onChange では打った文字をそのまま state に入れるだけにして、変換は欄を離れたときに1回だけにしています。
ライブラリの wanakana と比べる
ひらがなとカタカナの変換は、wanakana というライブラリの toHiragana() と toKatakana() でもできます。同じ文字を渡すと、結果が違うものがありました。
| 入力 | wanakana | この記事の関数 |
|---|---|---|
toHiragana('ラーメン') |
らあめん |
らーめん |
toHiragana('ヷ') |
U+3097(未割り当て) | わ と濁点の2文字 |
toHiragana('ヵヶ') |
ヵヶ(変わらない) |
ゕゖ |
toHiragana('ヽヾ') |
ヽヾ(変わらない) |
ゝゞ |
toKatakana('ねこ neko') |
ネコ ネコ |
ネコ neko |
wanakana の toHiragana() は、「ラーメン」の長音を「あ」にして「らあめん」にしました。また、wanakana はローマ字をかなにするライブラリでもあるので、toKatakana() は英字の「neko」も「ネコ」にします。wanakana の README にあるとおり、英字を残したいときは { passRomaji: true } を付けます。
ひらがなとカタカナを区別せずに探す
一覧から「ねこ」で探したときに「ネコ」も見つけたい場合は、比べる両方をひらがなにそろえてから includes() で調べます。kana.ts の includesIgnoringKana() がこれで、半角カナも全角にしてから比べます。検証環境では、次のようになりました。
| 対象の文字列 | 探す言葉 | 結果 |
|---|---|---|
ネコの手帳 |
ねこ |
true |
ねこのてちょう |
ネコ |
true |
ネコ ショップ |
ねこ |
true |
ラーメン |
らあめん |
false |
「ラーメン」は「らーめん」になるので、「らあめん」では見つかりません。長音まで同じとみなしたいときは、「ー」を前の文字の母音に置き換える処理を別に足す必要があります。
文字列どうしが等しいかだけを調べるなら、Intl.Collator でも比べられます。検証環境の Node.js では、new Intl.Collator('ja').compare('ねこ', 'ネコ') が 0 を返し、同じとみなしました。sensitivity を MDN の Intl.Collator の説明にある4つの値(base、accent、case、variant)のどれにしても、結果は 0 でした。半角の ネコ とも 0 です。濁点の違い(「ねこ」と「ねご」)は、accent と variant では区別し、base と case では同じとみなしました。
ただし compare() は文字列の全体を比べるので、「ネコの手帳」の中に「ねこ」があるかどうかは調べられません。また、['ネコ', 'ねこ', 'ねご', 'ネコ'] をこの compare で並べ替えると、['ネコ', 'ねこ', 'ネコ', 'ねご'] になり、ひらがなとカタカナは元の並びのまま混ざって残りました。