ReactでCSVファイルを読み込んで表に表示する方法
CSV ファイルを React の画面で表にするには、<input type="file"> で選ばれたファイルを文字列にし、CSV を解析するライブラリで行と列に分けてから、table 要素で表示します。この記事では、解析に Papa Parse を使いました。
大事なのは、文字列にする前に文字コードを確かめることです。UTF-8 として読めないファイルは Shift_JIS として読み直すようにすると、どちらのファイルでも文字化けせずに表になります。
検証環境は Ubuntu 24.04、Node.js 22.22.0、Chromium 153 です。使ったのは react / react-dom 19.3.1、@types/react 19.3.0、papaparse 5.7.0、@types/papaparse 5.5.2、typescript 7.0.2、esbuild 0.28.2、Playwright 1.63.0 です。.tsx を tsc で型チェックしてから esbuild で変換し、ファイルの選択は Playwright で行いました。テスト用の CSV は printf と iconv で作ったもので、Excel などの表計算ソフトで保存したファイルは試していません。大きなファイル(数万行以上)の速さも測っていません。動きは Chromium だけで確かめました。
カンマで分けるだけでは、表が崩れる
CSV は、値の中にカンマや改行、" を入れたいとき、その値を " で囲みます。囲んだ値の中の " は、"" と2つ重ねて書きます。CSV の形式をまとめた RFC 4180 の決まりです。たとえば、次のファイル(members.csv)の住所とメモの列がそうです。
名前,郵便番号,住所,メモ
佐藤,0600000,"北海道札幌市, 中央区","1行目
2行目"
鈴木,1000001,東京都千代田区,"""至急""と書かれた箱"
高橋,5300001,大阪府大阪市,<b>太字</b>
これを改行と , で分けるだけにすると、検証環境(Node.js 22)では次のようになりました。佐藤さんの行が5列と1列に割れ、" も値に残ります。
[
  [ '名前', '郵便番号', '住所', 'メモ' ],
  [ '佐藤', '0600000', '"北海道札幌市', ' 中央区"', '"1行目' ],
  [ '2行目"' ],
  [ '鈴木', '1000001', '東京都千代田区', '"""至急""と書かれた箱"' ],
  [ '高橋', '5300001', '大阪府大阪市', '<b>太字</b>' ],
  [ '' ]
]
同じ文字列を Papa Parse の Papa.parse に header: true と skipEmptyLines: true を付けて渡すと、1行目が列の名前になり、残りの行が、列の名前をキーにしたオブジェクトになりました。囲みの中のカンマと改行は値の一部として残り、"" は " 1つに戻っています。
[ '名前', '郵便番号', '住所', 'メモ' ]
[
  {
    '名前': '佐藤',
    '郵便番号': '0600000',
    '住所': '北海道札幌市, 中央区',
    'メモ': '1行目\r\n2行目'
  },
  {
    '名前': '鈴木',
    '郵便番号': '1000001',
    '住所': '東京都千代田区',
    'メモ': '"至急"と書かれた箱'
  },
  { '名前': '高橋', '郵便番号': '5300001', '住所': '大阪府大阪市', 'メモ': '<b>太字</b>' }
]
errors: []
1行目は meta.fields、行のオブジェクトの配列は data、解析中に見つかった問題は errors に入ります。Papa Parse のドキュメントの、結果のオブジェクトの説明にあるとおりです。skipEmptyLines: true は、ファイルの最後の改行のあとにできる空の行を、行として数えないために付けています。付けないで試すと、行が4つになり、4つ目は { '名前': '' } という中身のない行でした。errors にも、その行の列が足りないというエラーが入りました。
UTF-8 か Shift_JIS かを確かめて文字列にする
ファイルの中身は、File の arrayBuffer() でバイトのまま受け取り、TextDecoder で文字列にします。readCsvText は、まず UTF-8 として読み、読めなければ Shift_JIS として読み直す関数です。
// UTF-8 として読めなければ、Shift_JIS として読み直す
export async function readCsvText(file: File): Promise<{ text: string; encoding: string }> {
  const buffer = await file.arrayBuffer();
  try {
    // fatal: true にすると、UTF-8 として正しくないバイトがあったときに例外になる
    const text = new TextDecoder('utf-8', { fatal: true }).decode(buffer);
    return { text, encoding: 'UTF-8' };
  } catch {
    return { text: new TextDecoder('shift_jis').decode(buffer), encoding: 'Shift_JIS' };
  }
}
fatal を付けないと、TextDecoder は読めないバイトを置き換え文字(�)にして、そのまま文字列を返します。iconv で Shift_JIS にした sjis.csv で試すと、fatal なしでは1行目が ���i,���i,�� になり、fatal: true では TypeError が起きました。'shift_jis' で読み直すと 商品,価格,在庫 と正しく読めます。'shift_jis' という名前を使えることは、MDN のエンコーディングの一覧で確かめられます。
この関数が見分けるのは、UTF-8 か Shift_JIS かの2つだけです。EUC-JP など、ほかの文字コードのファイルも Shift_JIS として読まれるので、扱う必要があるなら、文字コードを画面で選べるようにするなどの工夫が要ります。
UTF-8 のファイルには、先頭に BOM(EF BB BF の3バイト)が付いていることがあります。members.csv も BOM 付きで作りました。TextDecoder は、ignoreBOM を指定しなければ BOM を読み飛ばします。検証環境でも、先頭の2文字は 名前 でした。ignoreBOM: true にすると、BOM は文字列の先頭に残ります。ただし、その文字列を Papa Parse 5.7.0 に渡したところ、1列目の名前は BOM のない 名前(2文字)になりました。
表を表示するコンポーネント
CsvImport は、ファイルが選ばれたら readCsvText と Papa.parse を通し、結果を state に入れて表を表示します。Papa.parse<Row> のように型を渡すと、result.data が Row[] になります。
import { useState, type ChangeEvent } from 'react';
import Papa from 'papaparse';
import { readCsvText } from './readCsvText';

type Row = Record<string, string>;

type Table = {
  fileName: string;
  encoding: string;
  fields: string[];
  rows: Row[];
  errors: Papa.ParseError[];
};

export function CsvImport() {
  const [table, setTable] = useState<Table | null>(null);

  async function handleChange(e: ChangeEvent<HTMLInputElement>) {
    const file = e.target.files?.[0];
    if (!file) return;

    const { text, encoding } = await readCsvText(file);
    const result = Papa.parse<Row>(text, { header: true, skipEmptyLines: true });
    setTable({
      fileName: file.name,
      encoding,
      fields: result.meta.fields ?? [],
      rows: result.data,
      errors: result.errors,
    });
  }

  return (
    <div>
      <label className="pick">
        CSVファイルを選ぶ
        <input type="file" accept=".csv,text/csv" onChange={handleChange} />
      </label>

      {table && (
        <>
          {table.errors.length > 0 && (
            <ul role="alert" className="errors">
              {table.errors.map((err, i) => (
                <li key={i}>
                  {err.row !== undefined ? `${err.row + 1}行目のデータ:` : ''}
                  {err.message}
                </li>
              ))}
            </ul>
          )}
          <table>
            <caption>
              {table.fileName}({table.encoding}、{table.rows.length}行)
            </caption>
            <thead>
              <tr>
                {table.fields.map((field) => (
                  <th key={field} scope="col">
                    {field}
                  </th>
                ))}
              </tr>
            </thead>
            <tbody>
              {table.rows.map((row, i) => (
                <tr key={i}>
                  {table.fields.map((field) => (
                    <td key={field}>{row[field]}</td>
                  ))}
                </tr>
              ))}
            </tbody>
          </table>
        </>
      )}
    </div>
  );
}
列は data のオブジェクトのキーではなく、meta.fields の順に並べています。こうすると、列が足りない行があっても、表の列がずれません。行の key に番号を使っているのは、CSV の行には決まった ID の列があるとは限らないからです。読み込むたびに表を丸ごと作り直すだけなので、番号で困ることはありません。
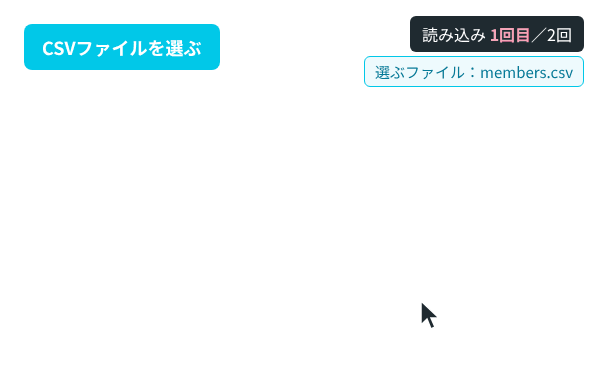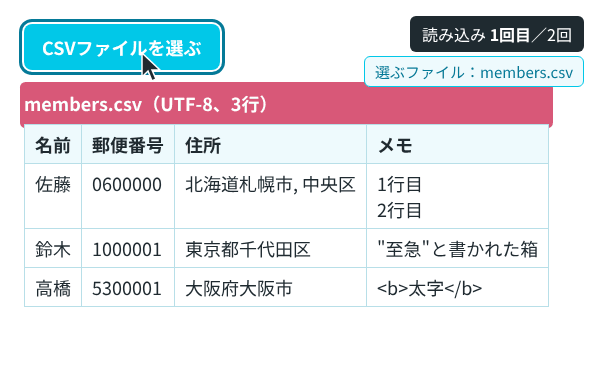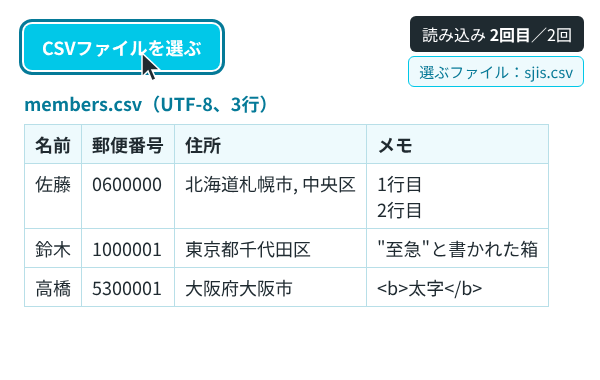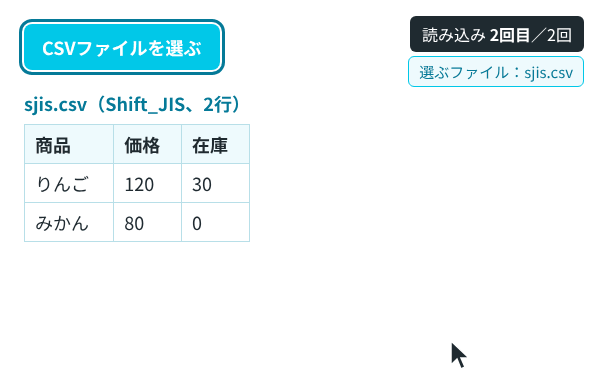
members.csv を選ぶと、表は次のように表示されました(各行の td の文字を並べたものです)。メモの列の改行は、CSS の white-space: pre-line で表の中でも改行して見せています。
caption: members.csv(UTF-8、3行)
th: [ '名前', '郵便番号', '住所', 'メモ' ]
tr: ["佐藤","0600000","北海道札幌市, 中央区","1行目\n2行目"]
tr: ["鈴木","1000001","東京都千代田区","\"至急\"と書かれた箱"]
tr: ["高橋","5300001","大阪府大阪市","<b>太字</b>"]
errors: []
td の中の b 要素の数: 0
最後の行の <b>太字</b> は、タグとしてではなく文字のまま表示されました。JSX の {row[field]} に入れた文字列は、HTML として解釈されないためです。CSV の中身は、ファイルを渡した人が自由に書けます。HTML として表示したくなっても、dangerouslySetInnerHTML に渡さないようにします。React のリファレンスの dangerouslySetInnerHTML の説明にも、信頼できない HTML を渡すと XSS の脆弱性につながると書かれています。
dynamicTyping: true を付けると、Papa Parse は数字に見える値を数値に変えます。検証環境では、郵便番号の 0600000 が 600000 になり、先頭の0が消えました。郵便番号や電話番号、商品コードのように、0で始まる値がある列では使わないでください。
列数が合わない行と、同じ名前の見出しを知らせる
CSV には、途中の行だけ列が足りない、または多すぎるものがあります。次の broken.csv は、2行目のデータの列が足りず、3行目は多すぎます。見出しの 名前 も2つあります。
id,名前,名前
1,佐藤,さとう
2,鈴木
3,高橋,たかはし,余り
これを読み込むと、画面の表と、エラーの一覧は次のようになりました。
caption: broken.csv(UTF-8、3行)
th: [ 'id', '名前', '名前_1' ]
tr: ["1","佐藤","さとう"]
tr: ["2","鈴木",""]
tr: ["3","高橋","たかはし"]
errors: [
  '2行目のデータ:Too few fields: expected 3 fields but parsed 2',
  '3行目のデータ:Too many fields: expected 3 fields but parsed 4'
]
Papa Parse は、列数が見出しと違う行があっても、解析をやめません。その行もデータに入れたうえで、errors に FieldMismatch のエラーを足します。エラーの row は、見出しを除いたデータの何番目か(0から数える)なので、画面では1を足して「2行目のデータ」と出しています。多すぎた値(余り)は、表には出ていません。行のオブジェクトの __parsed_extra という配列に入っています。
同じ名前の見出しは、2つ目以降が自動で 名前_1 のような名前に変わります。もとの名前は meta.renamedHeaders に { '名前_1': '名前' } として入ります。ドキュメントの header の説明にあるとおり、前の列の値が上書きされないようにするためです。この動きのおかげで、th と td の key に列の名前を使っても重なりません。なお、名前を変えたときには、Papa Parse がブラウザのコンソールに Duplicate headers found and renamed. と出しました。
エラーがあっても表は表示し、何行目のデータがおかしいかを一緒に見せると、どこを直せばよいかがファイルを渡した人に伝わります。
ファイルを選ぶボタンの見た目を変えるとき
ファイル選択の見た目を整えるために、input を label の中に入れ、label をボタンのように見せています。このとき input を display: none にすると、Tab キーで選べなくなります。MDN の <input type="file"> の例では、display: none や visibility: hidden にすると支援技術がこの input を操作できない要素とみなすため、opacity で隠すと説明されています。検証環境でも、display: none にしたページで Tab キーを押すと、フォーカスは body のままでした。検証用のページでは、input を大きさ1pxで透明にして、画面には見えないままフォーカスを受けられるようにしました。
.pick input { position: absolute; width: 1px; height: 1px; opacity: 0; }
.pick:focus-within { outline: 3px solid #067a98; outline-offset: 2px; }
検証環境で Tab キーを押すと、フォーカスは input に移り、Space キーでファイルを選ぶ操作が始まりました。Playwright の filechooser イベントが届いたことで確かめたもので、OS のファイル選択画面は操作していません。
accept=".csv,text/csv" は、ファイルを選ぶ画面で CSV を選びやすくするためのものです。MDN の <input type="file"> の説明にあるとおり、選ばれたファイルの種類を確かめる働きはありません。CSV 以外のファイルが選ばれても、Papa.parse の errors や表の中身で気づけるようにしておきます。