
FFmpegのloudnormで、動画ごとの音量をそろえる方法
FFmpeg の loudnorm フィルターを使うと、動画ごとに違う音の大きさを、同じ目標の値にそろえられます。撮った日や機材が違う動画をまとめて公開するとき、再生するたびに音量を上げ下げしなくて済むようにしたい場面で使う方法です。
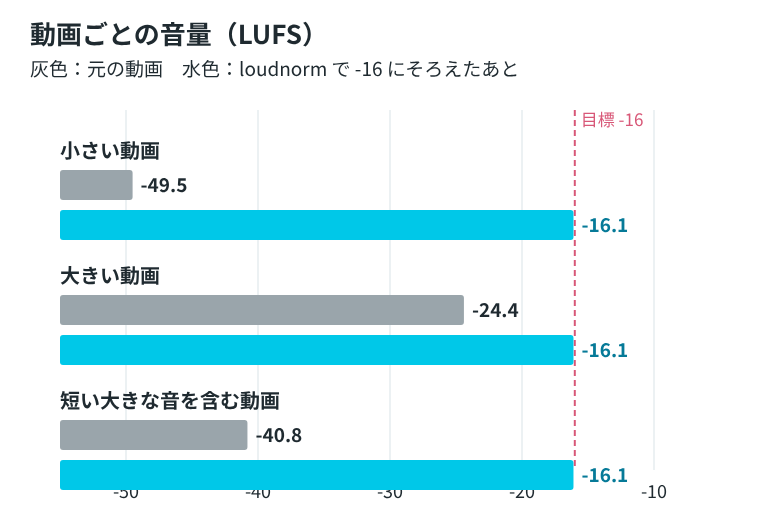
私は検証環境で、音の大きさが違う3本の動画を作り、loudnorm で -16 LUFS にそろえました。1回で処理すると、目標より 2.7 LU 大きい -13.3 LUFS になる動画がありました。先に音量を測り、その値を渡して2回に分けて処理すると、3本とも -16.1 LUFS にそろいました。
検証環境は Ubuntu 24.04.5、FFmpeg 6.1.1(Ubuntu のパッケージ 6.1.1-3ubuntu5)、CPU 4コアの仮想マシンです。音声は、FFmpeg で作ったピンクノイズを 300〜3000Hz に絞り、大きさを揺らした20秒の作り物で、後半の10秒は前半より約10dB大きくしています。人の声や音楽を録音した音声、モノラルや5.1chの音声、AAC 以外の音声コーデック、動画配信サービスに上げたあとの音量は試していません。
音の大きさは LUFS で測る
loudnorm は、EBU R128 という規格に沿って音の大きさ(ラウドネス)をそろえるフィルターです。FFmpeg のフィルターのドキュメントには、目標として次の3つを指定できると書かれています。
| オプション | 意味 | 初期値 |
|---|---|---|
I |
全体の平均的な大きさ(Integrated loudness、単位は LUFS) | -24 |
LRA |
大きい部分と小さい部分の幅(Loudness range、単位は LU) | 7 |
TP |
波形の山の高さの上限(True peak、単位は dBTP) | -2 |
この記事では I=-16:TP=-1.5:LRA=11 を目標にしました。LRA を初期値の 7 にしなかった理由は、あとの「2回目でも dynamic になる条件」で説明します。
まず、元の動画の大きさを測ります。print_format=json を付けて出力を捨てると、処理の最後に、測った値が JSON で表示されます。
ffmpeg -i quiet.mp4 -af loudnorm=I=-16:TP=-1.5:LRA=11:print_format=json -f null -小さい動画(quiet.mp4)では、次のように表示されました。input_ で始まる値が元の音の測定値です。
{
	"input_i" : "-49.09",
	"input_tp" : "-37.88",
	"input_lra" : "10.50",
	"input_thresh" : "-59.09",
	"output_i" : "-13.26",
	"output_tp" : "-1.50",
	"output_lra" : "5.20",
	"output_thresh" : "-23.26",
	"normalization_type" : "dynamic",
	"target_offset" : "-2.74"
}
1回で処理すると、目標からずれることがある
測った値を渡さずに、1回で処理するコマンドです。映像は -c:v copy でそのままコピーし、音声だけを作り直します。
ffmpeg -i quiet.mp4 -af loudnorm=I=-16:TP=-1.5:LRA=11 -ar 48000 -c:v copy -c:a aac -b:a 192k quiet-1pass.mp4できた動画を、loudnorm とは別の ebur128 フィルターで測り直しました。
| 動画 | 元の I | 1回で処理したあとの I |
|---|---|---|
| 小さい動画 | -49.5 LUFS | -13.3 LUFS |
| 大きい動画 | -24.4 LUFS | -13.3 LUFS |
| 短い大きな音を含む動画 | -40.8 LUFS | -16.1 LUFS |
2本は目標の -16 より 2.7 LU 大きくなりました。1回で処理すると、loudnorm は再生位置ごとに音量を少しずつ変える方式(JSON の normalization_type が dynamic)になります。大きい動画で、0.1秒ごとの短時間ラウドネスの変化を比べました。
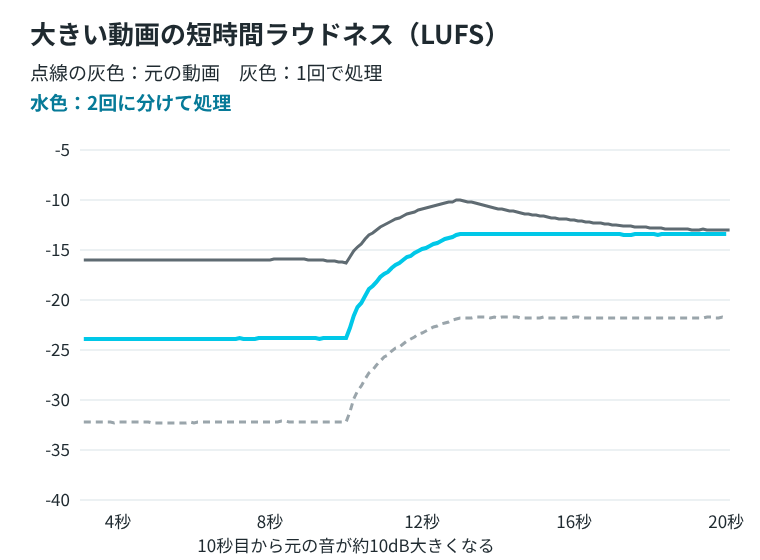
1回で処理した動画(実線の灰色)は、前半はちょうど -16 ですが、10秒目のあとは 13秒付近で -10.0 まで上がり、20秒目でも -13.0 でした。後半と前半の差も縮み、LRA は元の 10.5 LU から 5.6 LU になりました。2回に分けて処理した動画(水色)は、元の動画と同じ形のまま、全体が同じだけ大きくなっています。
1回で処理するとき(dynamic のとき)は、-ar 48000 を付けないとサンプリングレートが変わります。ドキュメントによると、dynamic の処理では、山の高さを正しく測るために 192kHz に変換されます。検証では、WAV に書き出すと 192000Hz、AAC で MP4 に書き出すと 96000Hz になりました。元の動画は 48000Hz です。後で説明する linear になった処理では、-ar を付けなくても 48000Hz のままでした。
測ってから2回に分けて処理すると、そろう
2回目では、1回目に測った値を measured_I、measured_LRA、measured_TP、measured_thresh の4つのオプションで渡し、linear=true を付けます。ドキュメントによると、この4つの値がそろっていて条件を満たすと、音全体に同じ倍率を掛けるだけの処理(linear)になります。
1回目に loudnorm が表示した値をそのまま渡すと、output_i は小さい動画が -16.40、大きい動画が -16.41 でした。ebur128 で測ると、どちらも -16.5 LUFS です。目標から 0.4〜0.5 LU ずれています。
原因は1回目の input_i でした。2回目の loudnorm が表示した元の音の大きさは -49.50 で、ebur128 で測った -49.5 と同じです。1回目だけが -49.09 と、0.41 大きく出ていました。
ずれ方は、音の終わり方によって変わりました。同じピンクノイズで、後半が大きい音、後半が小さい音、大きさが一定の音を作って比べた結果です。
| 音 | 1回目の input_i |
ebur128 の I |
|---|---|---|
| 後半が大きい | -22.68 | -23.1 |
| 後半が小さい | -23.60 | -23.1 |
| 大きさが一定 | -20.48 | -20.4 |
そこで、1回目は ebur128 で測ることにしました。peak=true を付けると、山の高さ(True peak)も表示されます。
ffmpeg -i quiet.mp4 -af ebur128=peak=true -f null -最後に出る要約から、I、Integrated loudness の Threshold、LRA、Peak の4つを使います。
  Integrated loudness:
    I:         -49.5 LUFS
    Threshold: -59.5 LUFS

  Loudness range:
    LRA:        10.5 LU
    Threshold: -69.5 LUFS
    LRA low:   -57.3 LUFS
    LRA high:  -46.9 LUFS

  True peak:
    Peak:      -37.9 dBFS
この値を2回目に渡します。
ffmpeg -i quiet.mp4 -af loudnorm=I=-16:TP=-1.5:LRA=11:measured_I=-49.5:measured_LRA=10.5:measured_TP=-37.9:measured_thresh=-59.5:linear=true:print_format=json -ar 48000 -c:v copy -c:a aac -b:a 192k quiet-2pass.mp4normalization_type は linear になり、output_i は -16.00 でした。できた動画を ebur128 で測ると -16.1 LUFS、LRA は元と同じ 10.5 LU です。
1回目の JSON には target_offset という値も出ます。これを offset に渡しても、linear になる場合は結果が変わりませんでした。offset を付けても付けなくても、output_i は同じ -16.40 です。loudnorm のソースコードでも、linear に切り替えるときに offset を目標と測定値の差で上書きしています。
2回目でも dynamic になる条件
ドキュメントには、linear にならず dynamic に戻る条件が2つ書かれています。
- 元の LRA が、目標の LRA より大きい
- 倍率を掛けたあとの山の高さが、目標の TP を超える
大きい動画(元の LRA は 10.5 LU)を、初期値の LRA=7 で2回目の処理をすると、normalization_type は dynamic になりました。output_i は -13.69 で、目標の -16 より 2.3 LU 大きくなりました。この記事で LRA=11 にしたのは、元の動画の LRA より大きくして linear にするためです。
短い大きな音を含む動画は、0.02秒の大きな音を2秒おきに混ぜたものです。元の山の高さは -17.5(ebur128 の表示は dBFS)で、-40.8 LUFS から -16 LUFS まで 24.8 LU 上げると、目標の -1.5 dBTP を超えます。LRA も 12.0 LU で、目標の 11 より大きいため、2回目も dynamic になりました。それでも I は -16.1 LUFS になり、3本そろいました。
ただし、この動画の山の高さは TP=-1.5 を超えていました。同じ処理を PCM の WAV に書き出しても -1.4 と上限をわずかに超え、AAC の MP4 では -0.9 まで高くなりました(どちらも ebur128 の表示で、単位は dBFS)。
映像はそのまま残る
-c:v copy で作った動画の映像を、小さい動画で元の動画と比べました。映像のデータの MD5 は、元の動画、1回で処理した動画、2回に分けて処理した動画(1回目に loudnorm の値を使ったもの)で同じでした。映像は作り直されていません。
小さい動画のこの3つのファイルで音声の長さを比べると、元の 20.000秒に対して、1回で処理した動画は 20.100秒、2回に分けて処理した動画は 20.010秒でした。映像はどれも 20.000秒です。
フォルダの動画をまとめてそろえるスクリプト
ここまでの手順を、フォルダ内の MP4 に順に行う Bash スクリプトにしました。1本ずつ ebur128 で測り、その値を loudnorm に渡します。
#!/bin/bash
# 使い方: bash normalize.sh 入力フォルダ 出力フォルダ
# フォルダ内の MP4 を、1本ずつ測ってから -16 LUFS にそろえる(映像はコピー)
set -eu
in=$1; out=$2
for f in "$in"/*.mp4; do
  r=$(ffmpeg -hide_banner -nostats -i "$f" -map 0:a:0 -af ebur128=peak=true -f null - 2>&1 | sed -n '/Summary:/,$p')
  I=$(echo "$r"   | awk '/ I:/{print $2; exit}')
  TH=$(echo "$r"  | awk '/Threshold:/{print $2; exit}')
  LRA=$(echo "$r" | awk '/LRA:/{print $2; exit}')
  TP=$(echo "$r"  | awk '/Peak:/{print $2; exit}')
  echo "$(basename "$f"): I=$I LRA=$LRA TP=$TP thresh=$TH"
  ffmpeg -hide_banner -loglevel error -y -i "$f" -map 0:v -map 0:a:0 \
    -af "loudnorm=I=-16:TP=-1.5:LRA=11:measured_I=$I:measured_LRA=$LRA:measured_TP=$TP:measured_thresh=$TH:linear=true" \
    -ar 48000 -c:v copy -c:a aac -b:a 192k "$out/$(basename "$f")"
done
Threshold は要約に2回出てくるので、最初の1回(Integrated loudness の値)だけを取り出しています。3本の動画で動かすと、次のように表示されました。
loud.mp4: I=-24.4 LRA=10.5 TP=-12.8 thresh=-34.4
peaky.mp4: I=-40.8 LRA=12.0 TP=-17.5 thresh=-52.9
quiet.mp4: I=-49.5 LRA=10.5 TP=-37.9 thresh=-59.5
できた3本を ebur128 で測ると、I はどれも -16.1 LUFS でした。