
CSSで、日本語のWebフォントを、使う文字の分だけ読み込む方法
日本語の Web フォントは、1ファイルで数 MB になることがあります。検証に使った IPAゴシックも、WOFF2 にして約3MB でした。フォントを文字の範囲ごとの小さなファイルに分け、@font-face の unicode-range にそれぞれの範囲を書くと、ブラウザーはページで使われている文字を含むファイルだけを読み込みます。ページに出てこない文字の分まで読み込ませず、フォントをサブセットにして必要な分だけ配信したいときに使えます。
検証環境は Ubuntu 24.04、Node.js 22.23.4、Playwright 1.63.0、Chromium 153(ヘッドレス)、fonttools 4.68.0 です。フォントは検証環境に入っている IPAゴシックを使い、検証用のサーバーから配信しました。Firefox と Safari、実際の回線での読み込みは試していません。各ブラウザーの対応バージョンは、互換性データ(@mdn/browser-compat-data 8.1.8)の値です。
unicode-range は、そのファイルが受け持つ文字を書く
unicode-range は、@font-face の中に書く記述子です。U+ に続けて、16進数のコードポイントを1つ(U+26)、範囲(U+3000-30FF)、または ? を使ったワイルドカード(U+4??)で書きます。カンマで区切って複数並べられます。省略すると U+0-10FFFF、つまりすべての文字です(CSS Fonts 4 の仕様の unicode-range の節)。
同じ font-family の名前で、範囲だけが違う @font-face をいくつも書くと、まとめて1つのフォントとして扱われます。ブラウザーは、表示する文字ごとに、その文字が範囲に入る @font-face のファイルだけを読み込みます。範囲が重なっているときは、後に書いた @font-face から順に調べます(仕様の、unicode-range で合成フォントを作る節)。
ブラウザーの対応は、互換性データでは Chrome 1・Edge 12・Firefox 36・Safari 3.1(iOS の Safari は 3)からです。
フォントを文字の範囲ごとのファイルに分ける
unicode-range は、ファイルを小さくする機能ではありません。先にフォントのファイルを分けておく必要があります。
ここでは、fonttools に入っている pyftsubset で、IPAゴシックを6つの WOFF2 に分けました。漢字は、CJK統合漢字の範囲(U+4E00〜9FFF)をコードポイントの順に4つに区切っています。
SRC=/usr/share/fonts/opentype/ipafont-gothic/ipag.ttf
pyftsubset "$SRC" --unicodes='*' --flavor=woff2 --layout-features='*' --output-file=full.woff2
pyftsubset "$SRC" --unicodes='U+0000-00FF' --flavor=woff2 --layout-features='*' --output-file=latin.woff2
pyftsubset "$SRC" --unicodes='U+3000-30FF,U+FF00-FFEF' --flavor=woff2 --layout-features='*' --output-file=kana.woff2
pyftsubset "$SRC" --unicodes='U+4E00-5FFF' --flavor=woff2 --layout-features='*' --output-file=kanji1.woff2
# kanji2(U+6000-6FFF)、kanji3(U+7000-7FFF)、kanji4(U+8000-9FFF)も同じように作る
WOFF2 で書き出すには、pip install fonttools brotli のように brotli も入れておきます。できたファイルの大きさは次のとおりです。
| ファイル | 範囲 | 大きさ |
|---|---|---|
full.woff2(分けない) |
すべて | 2,995,908 バイト |
latin.woff2 |
U+0000-00FF | 13,980 バイト |
kana.woff2 |
U+3000-30FF、U+FF00-FFEF | 36,208 バイト |
kanji1.woff2 |
U+4E00-5FFF | 535,532 バイト |
kanji2.woff2 |
U+6000-6FFF | 577,180 バイト |
kanji3.woff2 |
U+7000-7FFF | 593,316 バイト |
kanji4.woff2 |
U+8000-9FFF | 1,096,588 バイト |
kana.woff2 には、ひらがな(「あ」は U+3042)とカタカナ(「ア」は U+30A2)のほか、「、」(U+3001)「。」(U+3002)のような和文の記号と、全角の英数字(「A」は U+FF21)が入ります。
ページで使う文字を含むファイルだけが読み込まれた
分けたファイルを、同じ font-family の名前で並べます。
@font-face {
  font-family: "IPA Web";
  src: url("/fonts/latin.woff2") format("woff2");
  unicode-range: U+0000-00FF;
}
@font-face {
  font-family: "IPA Web";
  src: url("/fonts/kana.woff2") format("woff2");
  unicode-range: U+3000-30FF, U+FF00-FFEF;
}
@font-face {
  font-family: "IPA Web";
  src: url("/fonts/kanji1.woff2") format("woff2");
  unicode-range: U+4E00-5FFF;
}
/* kanji2〜kanji4 も同じように書く */

p {
  font-family: "IPA Web", sans-serif;
}
段落を1つだけ置いたページを開き、サーバーに来たフォントのリクエストを記録しました。文字を実際に描いたフォントは、Chrome DevTools Protocol の CSS.getPlatformFontsForNode で調べています。
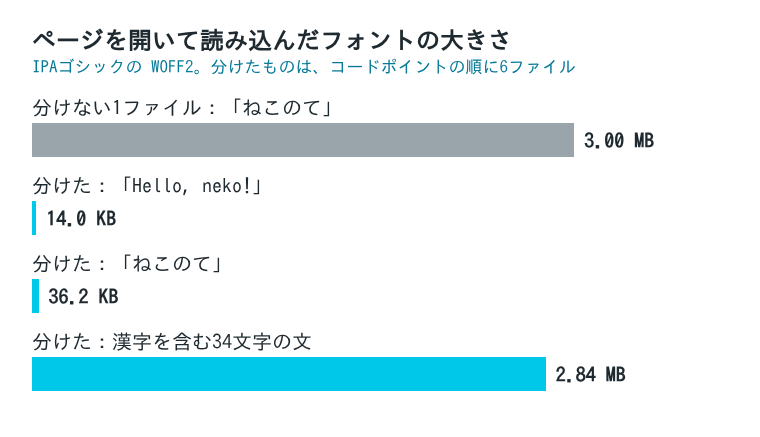
| 段落の文字 | 読み込まれたファイル | 合計 |
|---|---|---|
Hello, neko! |
latin.woff2 |
13,980 バイト |
ねこのて |
kana.woff2 |
36,208 バイト |
| 漢字を含む34文字の文 | kana.woff2 と、漢字の4ファイルすべて |
2,838,824 バイト |
どの場合も、段落の文字はすべて Web フォントで描かれていました。英語だけの段落では漢字のファイルを読み込まず、かなだけの段落ではラテン文字のファイルも読み込みませんでした。
一方、「猫の手も借りたいほど忙しい日に、文字の分だけフォントを読み込みます。」という34文字の文では、漢字の4ファイルがすべて読み込まれました。この文の漢字は、「借」「忙」「字」「分」が kanji1、「手」「日」「文」が kanji2、「猫」が kanji3、「読」「込」が kanji4 の範囲に入ります。10個の漢字が、4つの範囲のすべてに散らばっていました。漢字をコードポイントの順に大きく区切っただけでは、この程度の短い文でも漢字のファイルが全部読み込まれ、読み込む量は分けない場合とあまり変わりませんでした。
ファイルを分けずに unicode-range だけ書いても、全体が読み込まれる
分けていない full.woff2 に unicode-range: U+3000-30FF; だけを書き、「猫の手」を表示しました。
@font-face {
  font-family: "IPA Web";
  src: url("/fonts/full.woff2") format("woff2");
  unicode-range: U+3000-30FF;
}「の」が範囲に入るので、full.woff2 の 2,995,908 バイトがそのまま読み込まれました。「の」は Web フォントで描かれ、範囲の外の「猫」「手」は、端末に入っている別のフォントで描かれました。分けた kanji3.woff2 では「猫」を Web フォントで描けているので、ファイルの中に字形はあります。それでも、範囲の外なので使われませんでした。
仕様の unicode-range の節でも、範囲の外の文字にはそのフォントを使わないことになっています。また、MDN の unicode-range の説明にあるとおり、範囲の中の文字が1つでもページにあれば、ファイル全体がダウンロードされます。
表示されない文字と、あとから足した文字
display: none の要素にだけある文字では、その範囲のファイルは読み込まれませんでした。visibility: hidden の要素にある文字では、読み込まれました。MDN の visibility の説明にあるとおり、visibility: hidden の要素は、見えなくてもレイアウトに影響します。
段落に Hello とだけ書いたページを開いたあと、JavaScript で「猫」を書き足しました。開いた直後に読み込まれたのは latin.woff2 だけで、「猫」を足したところで kanji3.woff2 が読み込まれ、「猫」も Web フォントで描かれました。
document.fonts で各 @font-face の状態を見ると、読み込まれたものだけが loaded、ほかは unloaded のままでした。次の出力は「範囲=状態」をカンマで区切って並べたもので、U+3000-30FF, U+FF00-FFEF=unloaded は、範囲を2つ持つ kana.woff2 の1件です。
開いた直後:     U+0-FF=loaded, U+3000-30FF, U+FF00-FFEF=unloaded, U+4E00-5FFF=unloaded, U+6000-6FFF=unloaded, U+7000-7FFF=unloaded, U+8000-9FFF=unloaded
「猫」を足したあと: U+0-FF=loaded, U+3000-30FF, U+FF00-FFEF=unloaded, U+4E00-5FFF=unloaded, U+6000-6FFF=unloaded, U+7000-7FFF=loaded, U+8000-9FFF=unloaded
document.fonts の unicodeRange では、CSS に書いた U+0000-00FF が、先頭の0を省いた U+0-FF で返ってきました。仕様でも、ブラウザーは同じ文字の集合を表す別の書き方に直してよいことになっています。
Google Fonts の日本語フォントは、もっと細かく分けてある
比べるために、Google Fonts の Noto Sans JP の CSS を、太さを指定せずに検証環境の Chromium で読み込みました(2026年11月8日に取得)。
<link rel="stylesheet" href="https://fonts.googleapis.com/css2?family=Noto+Sans+JP&display=swap">返ってきた CSS には、@font-face が124個ありました。1番目の unicode-range は、ひと続きの範囲ではなく、飛び飛びのコードポイントを U+25ee8, U+25f23, U+25f5c, … と211項目並べたものです。124番目は、U+0000-00FF を含むラテン文字などの範囲です。
先ほどと同じ34文字の文を表示すると、文の漢字10字は9個の @font-face に分かれて入り、かなと「、」「。」はすべて120番目に入っていました。読み込まれた WOFF2 は11個、合計 144,264 バイトでした。11個には、文の文字がどれも入っていない124番目のファイルも含まれます。「ねこのて」だけのときも、120番目と124番目の2つ(合計 55,756 バイト)が読み込まれました。
フォントが違うので、ファイルの大きさを IPAゴシックの結果とそのまま比べることはできません。ただ、この文で読み込まれたのは124個のうち11個で、コードポイントの順に6つに区切った IPAゴシックのように、ほぼ全部のファイルが読み込まれることはありませんでした。
unicode-range は「このファイルが受け持つ文字」を書くだけで、読み込む量を減らせるのは、フォントのファイルそのものを分けた場合だけです。