Reactで、検索した言葉を結果の中で強調して表示する方法
検索結果の中で、検索した言葉だけに色を付けるには、文字列を「一致した部分」と「それ以外」に分け、一致した部分を <mark> 要素で囲んで描画します。分ける処理は、文字列の split に正規表現を渡せば1行で書けます。HTML の文字列を組み立てて dangerouslySetInnerHTML に渡す必要はありません。
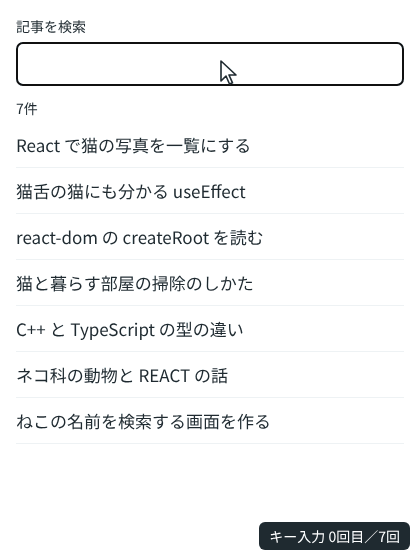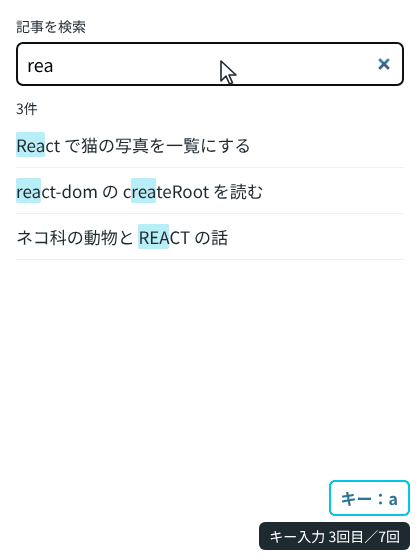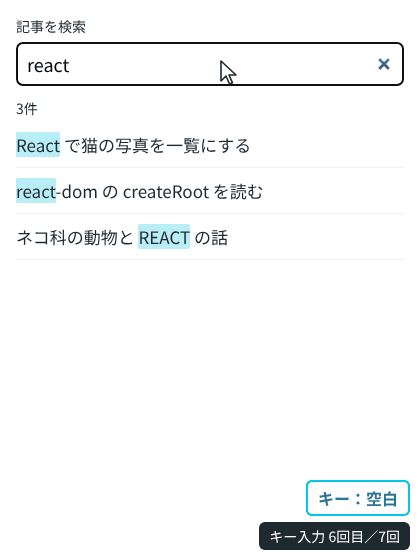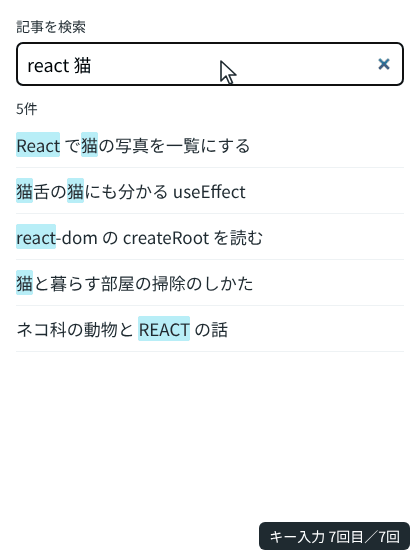
ブログ記事のタイトルを並べた一覧と、それを絞り込む検索欄を作り、強調の付き方と、うまくいかない書き方で何が起きるかを確かめました。
検証環境は Ubuntu 24.04、Node.js 22.22.0、Chromium 153 です。使ったのは react / react-dom 19.3.1、@types/react 19.3.0、typescript 7.0.2、esbuild 0.28.2、Playwright 1.63.0 です。.tsx を tsc で型チェックしてから esbuild で変換し、Playwright で Chromium を操作して、検索欄に入力したあとの各行の HTML を調べました。Firefox と Safari、日本語入力(IME)での変換中の動き、TypeScript で RegExp.escape を呼ぶときの型定義は試していません。
一致した部分を mark で囲む部品
強調を受け持つのは、次の Highlight です。表示する文字列 text と、検索語から作った正規表現 regExp を受け取ります。
type Props = {
  text: string;
  regExp: RegExp | null;
};

export function Highlight({ text, regExp }: Props) {
  if (!regExp) return text;
  // ( ) で囲んだ正規表現で split すると、一致した部分が奇数番目に入る
  const parts = text.split(regExp);
  return parts.map((part, i) => (i % 2 === 1 ? <mark key={i}>{part}</mark> : part));
}
ポイントは、正規表現全体を ( ) で囲んでおくことです。MDN の String.prototype.split() の説明にあるとおり、区切りの正規表現にキャプチャグループがあると、一致した部分も結果の配列に入ります。たとえば /(react)/i で「React で猫の写真を一覧にする」を分けると ['', 'React', ' で猫の写真を一覧にする'] になり、一致した部分は必ず、配列の添字(インデックス)が奇数の位置(1、3、…)に来ます。あとは、添字が奇数の要素だけを <mark> で囲めば済みます。
一致しなかった部分は、文字列のまま配列に入れて返しています。開発用のビルドで動かしても、key についての警告やエラーは出ませんでした。
MDN の mark 要素の説明には、<mark> の使いどころの例として、検索に一致した言葉を示すことが挙げられています。
検索語から正規表現を作る
検索欄の文字列から正規表現を作る関数は、次のとおりです。空白で区切った語のどれかに、大文字と小文字を区別せずに一致します。
// 正規表現で特別な意味を持つ文字の前に \ を付ける
export function escapeRegExp(text: string) {
  return text.replace(/[.*+?^${}()|[\]\\]/g, '\\$&');
}

// 空白で区切った語のどれかに、大文字と小文字を区別せずに一致する正規表現を作る
export function toSearchRegExp(query: string): RegExp | null {
  const words = query.trim().split(/\s+/).filter(Boolean);
  if (words.length === 0) return null;
  // 長い語を先に並べる(「猫」と「猫舌」なら「猫舌」を先に試す)
  const pattern = [...words]
    .sort((a, b) => b.length - a.length)
    .map(escapeRegExp)
    .join('|');
  return new RegExp(`(${pattern})`, 'i');
}
ここでは、次の3つのことをしています。
- 入力に含まれる
.や+などの記号の前に\を付けて、ただの文字として扱わせる - 長い語から順に並べる
- フラグに
iだけを付け、gを付けない
どれも、そうしなかったときに何が起きるかを、後の節で確かめています。
一覧の部品では、同じ正規表現を絞り込みと強調の両方に使います。検索欄が空のとき(空白だけのときも)は toSearchRegExp が null を返すので、全件をそのまま表示します。
import { useState } from 'react';
import { titles } from './data';
import { Highlight } from './Highlight';
import { toSearchRegExp } from './searchRegExp';

export function App({ items = titles }: { items?: string[] }) {
  const [query, setQuery] = useState('');
  const regExp = toSearchRegExp(query);
  const results = regExp ? items.filter((title) => regExp.test(title)) : items;

  return (
    <div className="search">
      <label>
        記事を検索
        <input type="search" value={query} onChange={(e) => setQuery(e.target.value)} />
      </label>
      <p className="count">{results.length}件</p>
      <ul>
        {results.map((title) => (
          <li key={title}>
            <Highlight text={title} regExp={regExp} />
          </li>
        ))}
      </ul>
    </div>
  );
}
検証環境で検索欄に「猫 猫舌」と入力したときの、2行目の HTML は次のとおりです。「猫舌」と「猫」の両方が、それぞれ <mark> で囲まれました。
<mark>猫舌</mark>の<mark>猫</mark>にも分かる useEffect「react」と入力すると、「React」「react」「REACT」のどれも強調され、<mark> の中には元の文字列の大文字・小文字がそのまま残りました。一方で、全角の「react」で検索すると、半角の「React」には一致せず0件でした。同じように、「ねこ」で検索すると「ねこ」を含む行だけが出て、「ネコ」や「猫」を含む行は出ません。全角と半角、ひらがなとカタカナを同じに扱う処理は、この記事では作っていません。
mark の色を変える
<mark> の見た目は CSS で変えられます。検証環境の Chromium では、CSS を何も書かないと、背景が黄色(rgb(255, 255, 0))、文字が黒(rgb(0, 0, 0))になりました。文字の色をまわりと同じにしたいときは、color: inherit を書きます。
mark {
  background-color: #b8eef7;
  color: inherit;
  border-radius: 2px;
}
入力をそのまま正規表現にすると、記号で画面が消える
escapeRegExp を通さずに、入力をそのまま new RegExp() に渡す書き方を作って比べました。
const parts = text.split(new RegExp(`(${query})`, 'i'));この書き方で「.」と入力すると、. が「任意の1文字」として扱われ、全8行(dangerouslySetInnerHTML の節で使う、HTML のような文字列の項目を1つ足した一覧)のすべての文字が、1文字ずつ <mark> で囲まれました。エスケープした正しい書き方では、一覧の7件に . を含む行がないので0件です。
「c++」と入力したときは、もっと困ったことになりました。/(c++)/i は正規表現として正しくないので、描画の途中で Invalid regular expression: /(c++)/i: Nothing to repeat というエラーが投げられ、検索欄ごと一覧が画面から消えました(#root の中の要素が0個になりました)。エスケープした書き方では、「C++ と TypeScript の型の違い」の「C++」が強調されます。
MDN の正規表現のガイドにあるとおり、特別な意味を持つ文字をただの文字として探すには、前に \ を付けます。escapeRegExp は、その \ を入力の記号に付けて回る関数です。
g フラグ付きの正規表現を test() で使い回すと、結果が抜ける
正規表現に g フラグを付け、絞り込みの filter の中で test() を使い回すと、一致するはずの行が抜けました。検証環境で「猫」と入力したところ、正しい書き方では3件なのに、g を付けた書き方では2件でした。抜けたのは「猫舌の猫にも分かる useEffect」です。
// うまくいかない書き方
const regExp = query ? new RegExp(`(${escapeRegExp(query)})`, 'gi') : null;
const results = regExp ? titles.filter((title) => regExp.test(title)) : titles;
MDN の RegExp.prototype.test() の説明によると、g フラグ付きの正規表現では、test() が true を返すたびに lastIndex が進み、次の test() は、別の文字列に対してでも、その位置から探し始めます。1行目の「React で猫の写真を一覧にする」で「猫」が見つかったあと、2行目の「猫舌の猫にも分かる useEffect」は、1行目で見つかった位置の直後(添字 8、先頭から9文字目)から探されました。2行目の「猫」は1文字目と4文字目(添字 0 と 3)にあるので、見つからなかったわけです。
split は、g がなくても、一致したところすべてで分けます。そのため、この記事の toSearchRegExp は i だけを付けています。
短い語が先だと、長い語の一部しか強調されない
toSearchRegExp から並べ替えを抜き、入力した順のまま 猫|猫舌 とつないだ書き方でも試しました。「猫 猫舌」と入力すると、「猫舌の猫にも分かる useEffect」の「猫舌」は、「猫」の1文字だけが強調されました。
<mark>猫</mark>舌の<mark>猫</mark>にも分かる useEffectMDN の選択(|)の説明にあるとおり、| でつないだ候補は左から順に試され、先に一致したものが使われます。そのため、「猫舌」の位置でも「猫」が先に一致し、「舌」は囲まれません。長い語から並べると、猫舌|猫 になり、「猫舌」がまとめて囲まれます(前の節の HTML のとおりです)。
dangerouslySetInnerHTML で強調を入れると、項目の中の HTML が実行される
文字列の replace で <mark>$1</mark> を差し込み、できた文字列を dangerouslySetInnerHTML で入れる書き方もできます。ただ、この書き方では、項目の文字列そのものも HTML として扱われます。
// うまくいかない書き方
const html = text.replace(new RegExp(`(${escapeRegExp(query)})`, 'gi'), '<mark>$1</mark>');
return <span dangerouslySetInnerHTML={{ __html: html }} />;
一覧に <img src="x" onerror="window.__xss = true"> という文字列の項目を1つ混ぜて試したところ、ページを開いただけで img 要素が作られ、onerror に書いた処理が実行されて window.__xss が true になりました。この記事の Highlight で同じ項目を表示した場合は、img 要素は作られず、文字列がそのまま画面に出ました。「img」で検索すると、その文字列の中の「img」だけが <mark> で囲まれます。
利用者が書いた文章など、信頼できない文字列を dangerouslySetInnerHTML に渡すと、その中のスクリプトが実行されるおそれがあります(XSS)。React の公式リファレンスにある dangerouslySetInnerHTML の説明でも、信頼できて無害化したデータにだけ使うように書かれています。検索の強調は、この記事のように要素を返す形で書けば、HTML の文字列を組み立てずに済みます。
RegExp.escape が使える環境なら、自作の関数は要らない
記号をエスケープする関数は、JavaScript の標準の機能に RegExp.escape() として加わりました。MDN の RegExp.escape() の説明では、\ を付けて回る処理を自分で書かずに、こちらを使うことが勧められています。MDN の互換性データでは、Chrome 136、Firefox 134、Safari 18.2、Node.js 24.0.0 から使えます。
検証環境では、Chromium 153 には RegExp.escape があり、Node.js 22.22.0 にはありませんでした。Chromium の中で、「react」「c++」「猫 猫舌」「.」「(」「a|b」の6つの検索語について、escapeRegExp で作った正規表現と RegExp.escape で作った正規表現で一覧の7件を split し、結果がすべて同じになることを確かめました。RegExp.escape('react') は、先頭の英字を \x72eact のように書き換えますが、一致する文字列は変わりません。
利用者の中に、RegExp.escape に対応していないブラウザを使う人がいるうちは、この記事の escapeRegExp を使います。RegExp.escape があるときだけそれを使い、ないときは自作の関数に切り替える方法もあります。