
Lighthouseでrobots.txtが無効と出たときの直し方
Lighthouse の SEO の欄に「robots.txt is not valid」(日本語のレポートでは「robots.txt が無効です」)と出たときは、その指摘を開くと、問題のある行の番号、その行の中身、エラーの理由が表になって並びます。この表を上から順に直せば、指摘は消えます。
robots.txt は、検索エンジンのクローラーに「サイトのどこを巡回してよいか」を伝えるファイルです。サイトのいちばん上(https://example.com/robots.txt)に置きます。Lighthouse のレポートでこの指摘を開くと、形式が間違っているとクローラーが巡回やインデックス登録の指定を理解できないことがある、という説明が出ます。Chrome for Developers にある、この監査の解説には、公開しているページが巡回されなくなったり、巡回させたくないページが巡回されたりする、という2種類の問題が起きうると書かれています。
私は検証環境で、6種類の間違いを入れた robots.txt を配信して Lighthouse を実行し、どの行にどんなエラーが出るかと、直すと消えることを確かめました。robots.txt がないとき、サーバーエラーを返すとき、robots.txt の代わりに HTML が返るときの結果も載せます。
検証環境は Ubuntu 24.04、Node.js 22.23.4、Lighthouse 13.6.0(npm で入れた CLI)、ブラウザは Google Chrome for Testing 153 のヘッドレスです。SEO の項目だけ(--only-categories=seo)を、初期設定のモバイル向けの条件で実行しました。ページと robots.txt は、検証環境で Node.js の小さなサーバーから 127.0.0.1 で配信しました。Chrome の DevTools の Lighthouse パネル、PageSpeed Insights、実際の検索エンジンのクローラーの動きは試していません。
6種類の間違いを入れた robots.txt で試す
検証に使った robots.txt です。1行目はコメントで、2行目から8行目にそれぞれ1つずつ間違いがあります。
# 猫ブログの robots.txt(間違いを含む版)
Disallow: /drafts/
User-agent: *
Disallow: admin/
Dissalow: /tmp/
Allow: /cats/$page
Noindex
Sitemap: /sitemap.xml
ページを配信したうえで、次のように Lighthouse を実行しました。Lighthouse は、調べるページの URL から /robots.txt を組み立てて取りにいきます。
npx lighthouse http://127.0.0.1:8101/ \
  --only-categories=seo \
  --output=json --output=html --output-path=./out/bad \
  --chrome-flags="--headless=new --no-sandbox" --quiet
SEO の点数は91でした。HTML のレポートで指摘を開くと、6行それぞれにエラーが出ています。
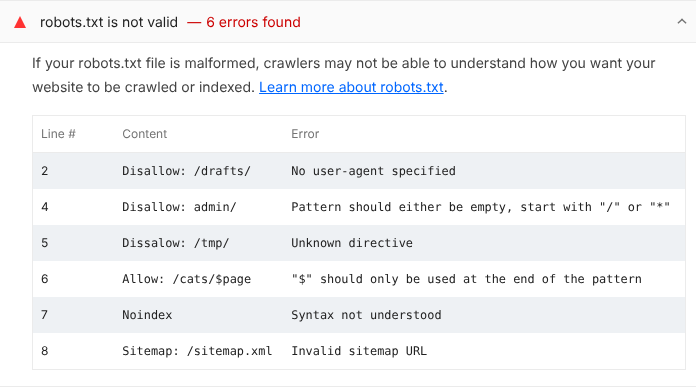
日本語のレポート(--locale=ja)では、見出しは「robots.txt が無効です」、件数は「6 件のエラーが見つかりました」になりました。ただし、表のエラーの理由は英語のままでした。
エラーの理由ごとの直し方
表に出たエラーの理由と、直し方は次のとおりです。
| 行 | 書いた内容 | エラーの理由 | 直し方 |
|---|---|---|---|
| 2 | Disallow: /drafts/ |
No user-agent specified | User-agent: の行より後ろに移す |
| 4 | Disallow: admin/ |
Pattern should either be empty, start with "/" or "*" | パスを / で始める(/admin/) |
| 5 | Dissalow: /tmp/ |
Unknown directive | つづりを Disallow に直す |
| 6 | Allow: /cats/$page |
"$" should only be used at the end of the pattern | $ はパスの最後にだけ置く |
| 7 | Noindex |
Syntax not understood | 行を消す |
| 8 | Sitemap: /sitemap.xml |
Invalid sitemap URL | 絶対 URL(https://example.com/sitemap.xml の形)にする |
Disallow や Allow は、User-agent の行の後ろに書きます。Chrome for Developers の解説には、最初の User-agent より前に置いた指示には、どのクローラーも従わないと書かれています。2行目の Disallow: /drafts/ は、ファイルにはあっても効いていない行です。
Allow と Disallow の値は、空にするか、/ か * で始めます。$ は、パスの最後にだけ置けます。
7行目の Noindex は、: がない行なので「Syntax not understood」になりました。Lighthouse 13.6.0 の、この監査のソースコードでは、空の行、コメント、「名前: 値」の形の行だけが受け付けられます。名前が User-agent、Disallow、Allow、Sitemap、Crawl-delay などの一覧にないときは、5行目のように「Unknown directive」になります。名前の大文字と小文字は区別しません。
Sitemap は、/sitemap.xml のような相対パスでは通りません。解説にも、絶対 URL を使うようにとあります。
直した robots.txt は次のとおりです。
# 猫ブログの robots.txt(直した版)
User-agent: *
Disallow: /drafts/
Disallow: /admin/
Disallow: /tmp/
Allow: /cats/*.html$

Sitemap: https://example.com/sitemap.xml
同じ条件で実行し直すと、監査は合格になり、SEO の点数は100になりました。
seo score: 100
weights: 11.043/11.043
[robots-txt] score=1 (binary)
  title: robots.txt is valid
[is-crawlable] score=1 (binary)
  title: Page isn’t blocked from indexing
failed seo audits: (none)
書き方は正しいのに指摘が出るとき
robots.txt の中身ではなく、サーバーの返し方で指摘が出ることもあります。中身や返し方を変えて試した結果は次のとおりです。
| robots.txt の返し方 | 監査の結果 | SEO の点数 |
|---|---|---|
| 直した robots.txt を 200 で返す | 合格 | 100 |
| ファイルがない(404) | 該当なし | 100 |
| 空のファイルを 200 で返す | 該当なし | 100 |
| サーバーエラー(500) | 不合格(Request for robots.txt returned HTTP status: 500) | 91 |
| robots.txt の代わりに HTML のページを 200 で返す | 不合格(15 errors found) | 91 |
| 先頭に BOM が付いている | 合格 | 100 |
| 改行が CRLF | 合格 | 100 |
robots.txt がないときは不合格ではなく「該当なし」になり、点数の計算から外れました。robots.txt を置いておらず、/robots.txt に404が返るサイトでは、この指摘は出ません。
サーバーエラーのときは、件数の代わりに HTTP のステータスが出ます。監査のソースでは、500以上のほかに 429(リクエストが多すぎる)も不合格になります。解説には、robots.txt がサーバーエラーを返すと、検索エンジンがサイト全体の巡回をやめることがあると書かれています。
気づきにくいのは、robots.txt の代わりに HTML が返る場合です。SPA の配信で使われる、どのパスにも index.html を返す設定のサーバーでは、robots.txt を置き忘れると、/robots.txt にもトップページの HTML が 200 で返ります。検証では、HTML の15行がすべて「Syntax not understood」になりました。表の Content の列に <!doctype html> が並んでいたら、robots.txt のファイルを置くか、/robots.txt だけは HTML を返さないようにサーバーの設定を見直してください。
書式が正しくても、ページの巡回を止めてしまう場合
書式が正しくても、内容によっては別の監査が不合格になります。次の robots.txt は書式に問題がないので、robots.txt の監査は合格(robots.txt is valid)でした。
User-agent: *
Disallow: /
一方で、すべてのパスの巡回を止めているので、「Page is blocked from indexing」(日本語では「ページのインデックス登録を行えません」)の監査が不合格になり、SEO の点数は63まで下がりました。
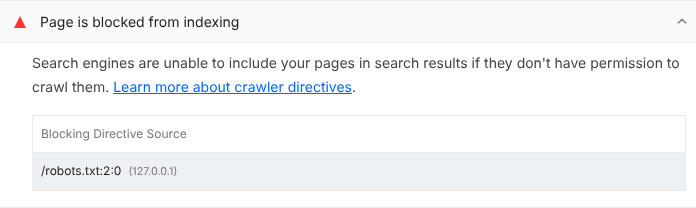
Lighthouse 13.6.0 の既定の設定ファイルでは、SEO の点数での robots-txt の重みは1です。巡回を止められているかを調べる is-crawlable は 93/23(約4.04)と重く、点数が大きく下がったのはこのためです。公開前のサイトで Disallow: / にしていた robots.txt を、公開のときに戻し忘れていないかも確かめてください。
Lighthouse が見ていないこと
この監査は、ページの URL と同じホストの /robots.txt を1つ取り、書式と HTTP のステータスを調べるだけです。どのパスを止めるべきかという中身の良し悪しは判定しません。Chrome for Developers の解説では、Lighthouse が調べない点として、robots.txt をドメインやサブドメインのいちばん上に置くことが挙げられています。同じ解説には、500 KiB を超えるファイルは検索エンジンが途中で読むのをやめることがあるので、disallow: /*.pdf のようなパターンでまとめて短くするように、とも書かれています。