
Reactで、貼り付けた一覧から重複した行を取り除く方法
一覧の重複を取り除くには、1行ずつに分けて Set に入れるのがいちばん短い書き方です。最初に出てきた順のまま、2回目以降の行が消えます。ただ、ほかの場所からコピーした一覧では、行末の空白や全角と半角の違いで、同じに見える行が別の行として残ります。そこで、比べるときに使う文字列だけをそろえ、残す行は最初に出てきたものにしました。
ここでは、貼り付けた一覧から重複した行を取り除く LineDeduper というコンポーネントを作りました。「前後の空白を無視する」「大文字と小文字を区別しない」「全角と半角を区別しない」「空の行を取り除く」の4つの比べ方をそれぞれオン・オフでき、結果はボタンでコピーできます。
検証環境は Ubuntu 24.04、Node.js 22.23.4、Chromium 153 です。使ったのは react / react-dom 19.3.1、@types/react 19.3.0、typescript 7.0.2、esbuild 0.28.2、Playwright 1.63.0 です。関数は Node.js で結果を確かめ、コンポーネントは tsc で型エラーがないことを確かめたうえで、StrictMode で包んだ開発用のビルドを幅 375px の Chromium で Playwright から操作しました。貼り付けは、Playwright でクリップボードに文字列を入れてから Ctrl+V を押して行いました。Firefox と Safari、スマートフォンの実機での動き、本番用のビルドでの速さは試していません。
new Set だけで取り除ける一覧と、残ってしまう一覧
いちばん短い書き方は、改行で分けて Set に入れ、配列に戻す書き方です。Set は同じ値を1つしか持たず、値を入れた順に取り出せます。
const unique = [...new Set(text.split('\n'))];検証環境の Node.js で 'りんご\nみかん\nりんご\nぶどう\nみかん' を渡すと、["りんご","みかん","ぶどう"] になりました。2回目の「りんご」と「みかん」だけが消え、並びは最初に出てきた順のままです。
ただ、Set は文字列が1文字でも違えば別の値として扱います。同じに見えても文字列としては違う行を含む一覧を、同じ書き方で試しました。
| 一覧 | new Set の結果 |
|---|---|
改行が \r\n の行と \n の行が混ざる |
"りんご\r" と "りんご" が両方残る |
| 末尾に半角の空白がある | "りんご" と "りんご " が両方残る |
| 先頭に全角の空白がある | "りんご" と " りんご" が両方残る |
| 大文字と小文字 | "Apple"
"apple"
"APPLE" がすべて残る |
| 全角の英数字と半角の英数字 | "ABC123" と "ABC123" が両方残る |
| 半角カタカナ | "カタカナ" と "カタカナ" が両方残る |
| 空の行が何行もある | 空の文字列 "" が1つ残る |
大文字と小文字を区別するかどうかのように、どこまでを同じ行とみなすかは一覧の中身によって変わります。そこで、この記事のコンポーネントでは、それぞれを利用者が選べるようにしました。
Chromium の入力欄に貼り付けた値には \r が残らなかった
表の1行目の \r は、検証環境の Chromium で <textarea> に貼り付けた場合には問題になりませんでした。\r\n で区切った11行の一覧をクリップボードに入れて Ctrl+V で貼り付けると、navigator.clipboard.readText() で読んだクリップボードの文字列には \r が11個ありました。一方、貼り付けたあとの入力欄の value には \r が1つもなく、\n が11個でした。
入力欄の値は \n だけになりますが、関数は入力欄以外から受け取った文字列にも使えるように、\r\n、\r、\n のどれでも行を分けるようにしています。
比べるときだけ文字列をそろえる関数
取り除く処理は dedupeLines.ts にまとめました。dedupeLines() は、残した行の配列と、2回以上出てきた行とその回数、元の行数を返します。
// 貼り付けた一覧から、重複した行を取り除く関数

export type DedupeOptions = {
  trim: boolean; // 行の前後の空白を無視して比べる
  ignoreCase: boolean; // 英字の大文字と小文字を区別しない
  normalizeWidth: boolean; // 全角と半角の違いを無視する(NFKC)
  dropEmpty: boolean; // 空の行(空白だけの行も含む)を取り除く
};

export type DedupeResult = {
  lines: string[]; // 残した行。最初に出てきた行を残す(前後の空白を無視するときは、空白を除いて残す)
  duplicates: { line: string; count: number }[]; // 2回以上出てきた行と、その回数
  total: number; // 元の行数
};

// \r\n(Windows)、\r、\n のどれでも1行に分ける。末尾の改行のあとの空の1行は数えない
export function splitLines(text: string): string[] {
  if (text === '') return [];
  const lines = text.split(/\r\n|\r|\n/);
  if (lines.at(-1) === '') lines.pop();
  return lines;
}

// 比べるときに使う文字列。全角と半角、大文字と小文字は、ここでだけそろえる
function toKey(line: string, options: DedupeOptions): string {
  let key = line;
  if (options.normalizeWidth) key = key.normalize('NFKC');
  if (options.ignoreCase) key = key.toLowerCase();
  return key;
}

export function dedupeLines(text: string, options: DedupeOptions): DedupeResult {
  const all = splitLines(text);
  const seen = new Map<string, { line: string; count: number }>();
  const lines: string[] = [];
  for (const raw of all) {
    const line = options.trim ? raw.trim() : raw;
    if (options.dropEmpty && line.trim() === '') continue;
    const key = toKey(line, options);
    const found = seen.get(key);
    if (found) {
      found.count += 1;
      continue;
    }
    seen.set(key, { line, count: 1 });
    lines.push(line);
  }
  const duplicates = [...seen.values()].filter((v) => v.count > 1);
  return { lines, duplicates, total: all.length };
}
残す行は変えず、比べる文字列だけを変える
Set に行をそのまま入れると、比べた文字列がそのまま結果になります。全角と半角をそろえて比べたいからといって、結果まで半角にしたいとは限りません。そこで Map のキーには比べるための文字列を入れ、値には最初に出てきた行と出てきた回数を持たせました。Map も、キーを入れた順に取り出せます。
4つをすべてオンにして、' Apple\napple\nApple\nみかん\nみかん \n\nぶどう\nAPPLE' を渡した結果です。
{"lines":["Apple","みかん","ぶどう"],"duplicates":[{"line":"Apple","count":4},{"line":"みかん","count":2}],"total":8}大文字と小文字、全角と半角の違う4つの「apple」は1つにまとまり、残ったのは最初の行の「Apple」です。全角の「Apple」や、すべて大文字の「APPLE」にはなりません。ただし前後の空白だけは、残す行からも取り除いています。最初の行の先頭にあった半角の空白は、結果には残りません。空白まで元のまま残すと、結果をコピーしたときに、行末に見えない空白が付いたままになるからです。
4つの比べ方に使ったメソッド
前後の空白は trim() で取り除きます。trim() は半角の空白だけでなく、全角の空白(U+3000)も取り除きました。表の「先頭に全角の空白がある」一覧は、「前後の空白を無視する」をオンにすると「りんご」1行になりました。
大文字と小文字は、toLowerCase() で小文字にそろえて比べます。
全角と半角は、normalize('NFKC') でそろえて比べます。全角の英数字は半角に、半角のカタカナは全角になり、「ABC123」と「ABC123」、「カタカナ」と「カタカナ」が同じ行になりました。ただ、NFKC は全角と半角以外の文字も変えます。検証環境の Node.js で、次の組み合わせを比べました。
| 組み合わせ | NFKC で比べた結果 |
|---|---|
| 「①」と「1」 | 同じ行になる |
| 「㈱」と「(株)」 | 同じ行になる |
| 「ガ」(半角の2文字)と「ガ」 | 同じ行になる |
| 「-」(U+FF0D)と「-」 | 同じ行になる |
| 「〜」(U+301C)と「~」(U+FF5E) | 別の行のまま |
番号付きの一覧で「①」と「1」を別の行として残したいときは、「全角と半角を区別しない」をオフにします。全角と半角を変換するときに NFKC で変わりすぎる文字と、半角カナの部分にだけかける方法は、「Reactで、全角と半角を変換する入力欄を作る方法」で詳しく扱いました。
空の行は、trim() したあとに空になる行を取り除きます。オフにしたときは、ほかの行と同じように、空の行を1行だけ残します。
入力欄と結果をコピーするボタンを付ける
import { useId, useMemo, useState } from 'react';
import { dedupeLines, type DedupeOptions } from './dedupeLines';

const optionLabels: [keyof DedupeOptions, string][] = [
  ['trim', '前後の空白を無視する'],
  ['ignoreCase', '大文字と小文字を区別しない'],
  ['normalizeWidth', '全角と半角を区別しない'],
  ['dropEmpty', '空の行を取り除く'],
];

export function LineDeduper({ initial = '' }: { initial?: string }) {
  const id = useId();
  const [text, setText] = useState(initial);
  const [options, setOptions] = useState<DedupeOptions>({
    trim: true,
    ignoreCase: false,
    normalizeWidth: false,
    dropEmpty: true,
  });
  // 最後にコピーした文字列。結果が変わったら「コピーしました」を消すために、中身で比べる
  const [copied, setCopied] = useState<string | null>(null);

  // 何万行も貼り付けたとき、ほかの state が変わるたびに数え直さないようにする
  const result = useMemo(() => dedupeLines(text, options), [text, options]);
  const output = result.lines.join('\n');
  const removedCount = result.total - result.lines.length;

  async function copy() {
    await navigator.clipboard.writeText(output);
    setCopied(output);
  }

  return (
    <div className="deduper">
      <label htmlFor={`${id}-input`}>一覧(1行に1つ)</label>
      <textarea id={`${id}-input`} rows={8} value={text} onChange={(e) => setText(e.target.value)} />
      <fieldset>
        <legend>比べ方</legend>
        {optionLabels.map(([key, label]) => (
          <label key={key}>
            <input
              type="checkbox"
              checked={options[key]}
              onChange={(e) => setOptions({ ...options, [key]: e.target.checked })}
            />
            {label}
          </label>
        ))}
      </fieldset>
      <p aria-live="polite">
        {result.total}行 → {result.lines.length}行({removedCount}行を取り除きました)
      </p>
      <label htmlFor={`${id}-output`}>重複を取り除いた一覧</label>
      <textarea id={`${id}-output`} rows={8} value={output} readOnly />
      <button type="button" onClick={copy} disabled={output === ''}>
        {copied === output ? 'コピーしました' : '結果をコピー'}
      </button>
      {result.duplicates.length > 0 && (
        <details>
          <summary>2回以上出てきた行({result.duplicates.length}種類)</summary>
          <ul>
            {result.duplicates.map((d) => (
              <li key={d.line}>
                <code>{d.line}</code> … {d.count}回
              </li>
            ))}
          </ul>
        </details>
      )}
    </div>
  );
}.deduper {
display: grid;
gap: 8px;
max-width: 560px;
}
.deduper textarea {
font: inherit;
white-space: pre;
overflow-x: auto;
}
.deduper fieldset {
display: flex;
flex-wrap: wrap;
gap: 4px 16px;
margin: 0;
}
.deduper button {
justify-self: start;
}
.deduper ul {
margin: 4px 0 0;
padding-left: 1.5em;
}
.deduper code {
white-space: pre;
background: #eefafd;
}結果は state に持たず、入力した文字列と比べ方から、レンダーのたびに計算します。ただし、何万行も貼り付けたあとに「コピーしました」の表示が変わるだけで数え直さないよう、useMemo で包みました。useMemo は、依存する値(ここでは text と options)が前回と変わらなければ、前回の結果をそのまま返します。
結果は、もう1つの <textarea> に readOnly を付けて出しました。何万行あっても1つの要素で済み、利用者が範囲を選んでコピーすることもできます。ボタンでのコピーには navigator.clipboard.writeText() を使っています。「コピーしました」の表示は、コピーした文字列と今の結果が同じときだけ出します。比べ方を変えて結果が変わると、ボタンの文字は「結果をコピー」に戻ります。
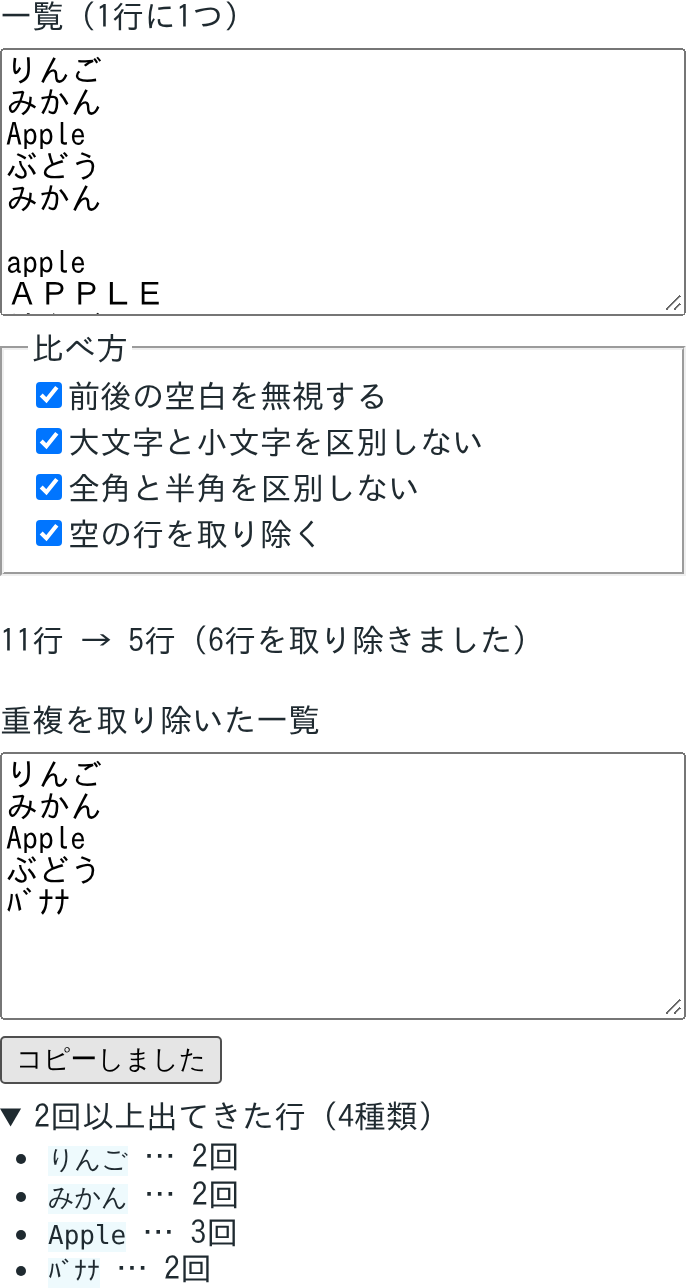
画面の見本は、次の11行の一覧です(2行目の「みかん」の後ろに半角の空白があり、6行目は空の行)。
りんご
みかん
Apple
ぶどう
みかん

apple
APPLE
りんご
バナナ
バナナ
Playwright で貼り付けてから比べ方を1つずつ変えると、結果の行数は次のように変わりました。
| 比べ方 | 結果 |
|---|---|
| 初期状態(前後の空白を無視する、空の行を取り除く) | 8行。「みかん」が1つになり、空の行と2回目の「りんご」が消える |
| +大文字と小文字を区別しない | 7行。「apple」が「Apple」にまとまる |
| +全角と半角を区別しない | 5行。「APPLE」が「Apple」に、「バナナ」が「バナナ」にまとまる |
| 上の状態から「前後の空白を無視する」を外す | 6行。「みかん 」と「みかん」が別々に残る |
全角と半角をそろえたときに残ったのは、先に出てきた半角の「バナナ」です。比べるときだけ文字列をそろえているので、どちらの書き方で残るかは、一覧の中で先に出てきた行で決まります。
何万行もある一覧を貼り付けたとき
重複を取り除く書き方には、filter() と indexOf() で「最初に出てきた位置が自分の位置と同じ行」だけを残す書き方もあります。indexOf() は、行ごとに配列を先頭から探します。ちょうど半分が重複する item-123 のような半角英数字の一覧を作り、検証環境の Node.js で3回ずつ測った最短の時間を比べました。
| 行数 | new Set |
filter() と indexOf() |
dedupeLines()(4つともオン) |
|---|---|---|---|
| 1,000行 | 0.1ms | 0.5ms | 0.3ms |
| 1万行 | 0.8ms | 44.1ms | 2.8ms |
| 10万行 | 11.8ms | 4,594.2ms | 32ms |
10万行では、filter() と indexOf() の書き方は4秒以上かかりました。dedupeLines() は new Set よりは遅いものの、32ms でした。
ブラウザでも、同じ10万行の一覧で操作にかかる時間を測りました。貼り付けと入力は行数の表示が変わるまで、チェックボックスは外す操作が終わるまでの時間です。開発用のビルドで、1回ずつ測りました。
| 操作 | かかった時間 |
|---|---|
| 10万行を貼り付ける | 2,686ms |
| 貼り付けたあと、末尾に1文字入力する | 1,523ms |
| チェックボックスを1つ外す | 983ms |
同じページの中で、チェックボックスを外したあとの比べ方のまま dedupeLines() だけを3回測ると、35〜61ms でした。数値を比べると、1文字の入力にかかった1.5秒ほどのうち、ほとんどは dedupeLines() 以外にかかっています。