
Reactで、2つの文章がどれだけ似ているかを数値で出す方法
2つの文章がどれだけ似ているかは、文字の並びを比べて0〜1の数にできます。1文字ずつの書き換えの回数から出す「編集距離」と、隣り合う2文字の組を比べる「ダイス係数」の2つを、ライブラリを使わずに TypeScript で書き、React のコンポーネントで並べて表示します。どちらも文字の並びだけを見るので、「ねこ」と「猫」のように、意味が同じでも字が違えば似ていないと判定されます。
検証環境は Ubuntu 24.04、Node.js 22.23.4(ICU 78.3)、Chromium 153 です。使ったのは React 19.3.1、TypeScript 7.0.2、esbuild 0.28.2、Playwright 1.63.0、fastest-levenshtein 1.0.16 です。.tsx を tsc で型チェックしてから esbuild で本番用にビルドし、Playwright で入力欄を操作して確かめました。Firefox、Safari、スマートフォンのブラウザ、日本語入力(IME)での入力は試していません。計算時間は Node.js で測り、ブラウザの中では測っていません。単語の意味まで比べる方法(形態素解析や、文章をベクトルにする方法)も扱っていません。
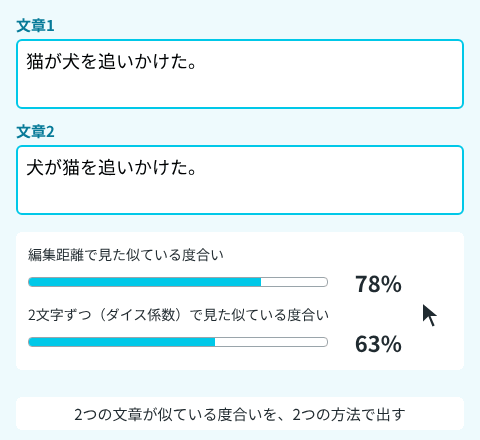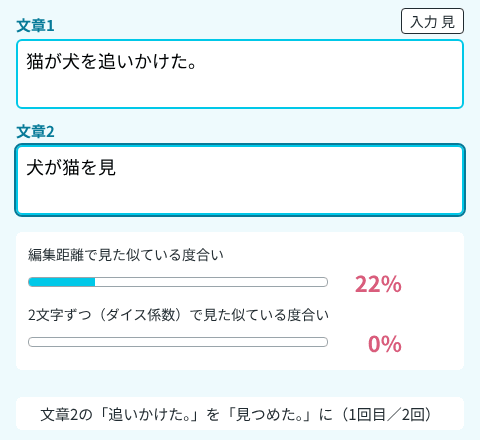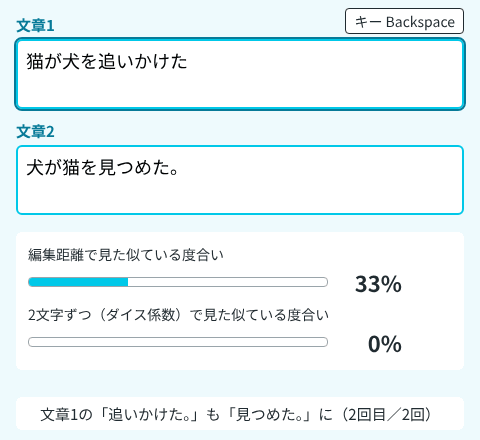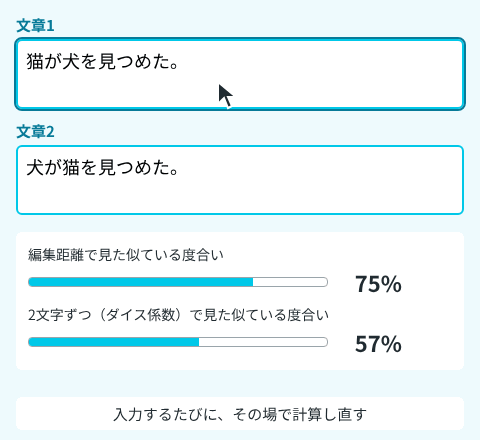
GIF の下の帯の説明、右上のキーの表示、カーソルと押した位置の輪は、撮影のために重ねたものです。キーボードで操作しているあいだは、カーソルを隠しています。
2つの方法は、何を数えているか
編集距離(レーベンシュタイン距離)は、一方の文章をもう一方に変えるのに要る、1文字の挿入・削除・置き換えの最小の回数です(Apache Commons Text の LevenshteinDistance のソースコードにある説明)。「猫が犬を追いかけた」と「犬が猫を追いかけた」なら、「猫」と「犬」を1回ずつ置き換えればよいので、距離は2です。ここでは、距離を長いほうの文字数で割り、1から引いた値を「似ている度合い」にしました。9文字で距離が2なら、1 − 2/9 で約78%です。
ここでは、隣り合う2文字の組(bigram)を比べる形のダイス係数を使います。文章を2文字ずつの組に分け、2つの文章で共通する組がどれだけあるかを数えます。npm の string-similarity は、README で Dice's Coefficient にもとづくと説明しています。ソースコードでは「2 ×(共通する組の数)÷(両方の組の数の合計)」で計算しています。ただし README の冒頭に、もう保守していないと書かれています。そこで、同じ式の関数を自分で書きました。
比べる前に、文字をそろえて1文字ずつに分ける
全角と半角、大文字と小文字、句読点の有無で値が下がらないように、比べる前に文字をそろえます。normalize('NFKC') は、全角の英数字を半角にするような、互換の関係にある文字を同じ形にする正規化です(MDN の normalize() のページ)。そのあと小文字にし、空白と句読点を消します。正規表現の \p{P} は、Unicode の文字の分類で句読点にあたる文字に一致します。
1文字ずつに分けるときは、Intl.Segmenter に granularity: 'grapheme' を渡します。MDN の Intl.Segmenter() のページにあるとおり、人が1文字と感じる単位(書記素クラスター)で区切ります。文字列の length は UTF-16 のコード単位で数えるので、絵文字では1文字が2以上になります。
"🐈⬛と遊ぶ".length = 7, "🐈と遊ぶ".length = 5
fastest-levenshtein の distance: 2
書記素で分けた levenshtein : 1黒猫の絵文字「🐈⬛」と猫の絵文字「🐈」の違いは、見た目では1文字の置き換えです。文字列をそのまま npm の fastest-levenshtein の distance() に渡すと距離は2、書記素に分けてから比べると1になりました。
似ている度合いを計算する関数
toChars() で文字をそろえて分け、editSimilarity() と diceSimilarity() に渡します。どちらも0〜1の数を返します。
const graphemes = new Intl.Segmenter('ja', { granularity: 'grapheme' });

// 全角・半角と大文字・小文字をそろえ、空白と句読点を除いてから、1文字ずつ(書記素ごと)の配列にする
export function toChars(text: string): string[] {
  const s = text.normalize('NFKC').toLowerCase().replace(/[\s\p{P}]/gu, '');
  return Array.from(graphemes.segment(s), (g) => g.segment);
}

// レーベンシュタイン距離:a を b にするのに要る、1文字の挿入・削除・置き換えの最小の回数
export function levenshtein(a: string[], b: string[]): number {
  if (a.length < b.length) [a, b] = [b, a]; // 短いほうを横に並べて、配列を小さくする
  let prev = Array.from({ length: b.length + 1 }, (_, j) => j);
  for (let i = 1; i <= a.length; i++) {
    const cur = [i];
    for (let j = 1; j <= b.length; j++) {
      const cost = a[i - 1] === b[j - 1] ? 0 : 1;
      cur[j] = Math.min(prev[j] + 1, cur[j - 1] + 1, prev[j - 1] + cost);
    }
    prev = cur;
  }
  return prev[b.length];
}

// 編集距離をもとにした似ている度合い(0〜1)。長いほうの文字数で割る
export function editSimilarity(a: string[], b: string[]): number {
  const len = Math.max(a.length, b.length);
  return len === 0 ? 1 : 1 - levenshtein(a, b) / len;
}

// 隣り合う2文字(bigram)ごとの回数。1文字しかないときは、その1文字を使う
function bigrams(chars: string[]): Map<string, number> {
  const m = new Map<string, number>();
  if (chars.length === 1) m.set(chars[0], 1);
  for (let i = 0; i < chars.length - 1; i++) {
    const g = chars[i] + chars[i + 1];
    m.set(g, (m.get(g) ?? 0) + 1);
  }
  return m;
}

// ダイス係数(0〜1):2 ×(共通する bigram の数)÷(両方の bigram の数の合計)
export function diceSimilarity(a: string[], b: string[]): number {
  const A = bigrams(a), B = bigrams(b);
  let sizeA = 0, sizeB = 0, common = 0;
  for (const n of A.values()) sizeA += n;
  for (const [g, n] of B) {
    sizeB += n;
    common += Math.min(n, A.get(g) ?? 0);
  }
  return sizeA + sizeB === 0 ? 1 : (2 * common) / (sizeA + sizeB);
}
levenshtein() は、長いほうの文章の先頭 i 文字と、短いほうの先頭 j 文字の距離を並べた表を、左上から1行ずつ埋めていきます。持つのは1つ前の行と今の行の2行だけです。同じ組が何回も出てくる文章では、diceSimilarity() は少ないほうの回数だけを共通として数えます。両方とも空の文章は、100%としました。
levenshtein() が正しい距離を出しているかは、fastest-levenshtein の distance() と比べて確かめました。漢字・ひらがな・英数字を混ぜた0〜29文字のランダムな文字列2000組で、距離はすべて一致しました(絵文字は入れていません)。
2つの値が分かれる文章
いくつかの組み合わせで、2つの値を出しました。
| 文章1 | 文章2 | 編集距離 | ダイス係数 |
|---|---|---|---|
| 猫が犬を追いかけた。 | 犬が猫を追いかけた。 | 77.8% | 62.5% |
| 明日の会議は10時からです | 明日の会議は10時からです。 | 100.0% | 100.0% |
| Hello, World! | hello world | 100.0% | 100.0% |
| 東京都に住んでいます | 東京に住んでいる | 70.0% | 62.5% |
| 今日は晴れています | 明日は雨が降ります | 44.4% | 25.0% |
| 猫が好きです | です好き猫が | 33.3% | 60.0% |
| 猫 | 猫が好き | 25.0% | 0.0% |
| ねこ | 猫 | 0.0% | 0.0% |
全角の数字と句読点、大文字と空白の違いは、比べる前にそろえたので、どちらも100%になりました。
文の中の部分を入れ替えた「猫が好きです」と「です好き猫が」では、2つの値の大小が逆になりました。編集距離は文字の位置がずれると置き換えが増えるので33.3%まで下がります。ダイス係数は「猫が」「好き」「です」の組がそのまま残るので60.0%でした。反対に「今日は晴れています」と「明日は雨が降ります」のように、同じ位置に同じ文字(「日」「は」「ま」「す」)が飛び飛びにある文章では、編集距離のほうが高く出ます。
1文字だけの文章では、ダイス係数は2文字の組を作れません。「猫」と「猫が好き」は、片方が1文字なので0%になりました。「ねこ」と「猫」は、どちらの方法でも0%です。意味が同じかどうかは、文字の並びだけでは分かりません。
2つの値を並べて表示するコンポーネント
コンポーネントでは、2つの文章を state に持ちます。似ている度合いは state にせず、レンダーのたびに計算します。React の公式ドキュメントにある、既存の props や state から計算できるものは、レンダー中に計算するという考え方に沿った書き方です。値は <meter> の棒と、パーセントの数字で見せます。MDN の <meter> のページのとおり、min と max を省くと0〜1の範囲になりますが、ここでは明示しています。
import { useId, useState } from 'react';
import { diceSimilarity, editSimilarity, toChars } from './similarity';

const percent = (x: number) => `${Math.round(x * 100)}%`;
// 編集距離は(文字数)×(文字数)回の計算になるので、2000字どうしを超えたら計算しない
const MAX_CELLS = 2000 * 2000;

export function TextSimilarity() {
  const [a, setA] = useState('猫が犬を追いかけた。');
  const [b, setB] = useState('犬が猫を追いかけた。');
  const idA = useId();
  const idB = useId();

  const charsA = toChars(a);
  const charsB = toChars(b);
  const edit = charsA.length * charsB.length <= MAX_CELLS ? editSimilarity(charsA, charsB) : null;
  const dice = diceSimilarity(charsA, charsB);

  return (
    <div className="text-similarity">
      <label htmlFor={idA}>文章1</label>
      <textarea id={idA} rows={2} value={a} onChange={(e) => setA(e.target.value)} />
      <label htmlFor={idB}>文章2</label>
      <textarea id={idB} rows={2} value={b} onChange={(e) => setB(e.target.value)} />

      <dl>
        <dt>編集距離で見た似ている度合い</dt>
        <dd>
          {edit === null ? (
            <output>長すぎるため計算しません</output>
          ) : (
            <>
              <meter min={0} max={1} value={edit} /> <output>{percent(edit)}</output>
            </>
          )}
        </dd>
        <dt>2文字ずつ(ダイス係数)で見た似ている度合い</dt>
        <dd>
          <meter min={0} max={1} value={dice} /> <output>{percent(dice)}</output>
        </dd>
      </dl>
    </div>
  );
}
MAX_CELLS は、2つの文章の文字数(句読点などを除いたあと)の積が、2000字どうしの分を超えたら編集距離を計算しないための上限です。この上限を決めた理由は、次の節で測った計算時間にあります。
Playwright で Chromium を操作して確かめたところ、最初の表示は78%と63%でした。文章2を「犬が猫を見つめた。」に変えると、33%と0%になりました。全角の「HELLO、world!」と半角の「hello world」はどちらも100%です。「猫」を2000字ずつ入れると、2つとも100%と出ました。片方を2001字にすると、編集距離の欄は「長すぎるため計算しません」になり、ダイス係数だけが出ました(表示は丸めて100%)。
長い文章で計算にかかる時間
編集距離は、2つの文章の文字数を掛けた回数だけ表を埋めるので、文章が長くなると時間が急に増えます。ダイス係数は、組を1回ずつ数えるだけです。検証環境の Node.js で、同じ長さの文章どうしを比べる時間を測りました。文章には空白や句読点を入れず、toChars() で除いても字数が変わらないようにしています。最初の3回は慣らしとして捨て、続く11回の中央値を取りました。
| 入力の長さ | 編集距離 | ダイス係数 |
|---|---|---|
| 1000字どうし | 12.8ms | 0.8ms |
| 2000字どうし | 40.1ms | 1.4ms |
| 5000字どうし | 291.4ms | 4.2ms |
| 10000字どうし | 1204.7ms | 12.7ms |
文字数が10倍になると、編集距離の時間は約94倍、ダイス係数は約16倍でした。このコンポーネントは、1文字入力するたびに計算し直します。Node.js で測った値では、1万字どうしの編集距離は1回の計算に約1.2秒かかっていました。2000字どうしで約40ミリ秒だったことを目安に、上限を2000字どうしにしました。ダイス係数は1万字どうしでも約13ミリ秒だったので、上限を超えても計算を続けています。