
Reactで、文章に出てくる単語の回数を数える方法
文章を Intl.Segmenter で単語に分け、Map で単語ごとの回数を数えて、多い順に10語を表にします。日本語のように単語の間に空白がない文章も、単語に分けられます。React で持つ state は、文章と「ひらがなだけの語は数えない」のチェックの2つだけで、回数はレンダーのたびに文章から計算します。
検証環境は Ubuntu 24.04、Node.js 22.23.4(ICU 78.3)、Chromium 153 です。使ったのは React 19.3.1、TypeScript 7.0.2、esbuild 0.28.2、Playwright 1.63.0 です。.tsx を tsc で型チェックしてから esbuild で本番用にビルドし、Playwright で入力欄を操作して確かめました。Firefox、Safari、スマートフォンのブラウザ、日本語入力(IME)での入力は試していません。ブラウザの中での計算時間も測っていません。形態素解析のライブラリを使う方法も扱っていません。
Intl.Segmenter で、文章を単語に分ける
Intl.Segmenter に granularity: 'word' を渡すと、文字列をその言語の単語の区切りで分けます(MDN の Intl.Segmenter() コンストラクターのページ)。日本語の文章を渡すと、次のように分かれました。かっこで囲んだものは、isWordLike が false だった区切りです。
"猫は窓辺で眠る。猫は毎日よく眠る。"
["猫","は","窓辺","で","眠る","(。)","猫","は","毎日","よく","眠る","(。)"]
"The cat sat. the Cat ran!"
["The","( )","cat","( )","sat","(.)","( )","the","( )","Cat","( )","ran","(!)"]
"🐈⬛と🐈。"
["(🐈⬛)","と","(🐈)","(。)"]MDN の containing() のページによると、isWordLike は、区切りが文字・数字・漢字などでできているときに true になります。句点や空白、「!」は false でした。絵文字も false だったので、isWordLike で絞ると絵文字は数えられません。
単語ごとの回数を数える関数
数える関数 countWords() は、isWordLike が true の区切りだけを取り出し、Map に単語と回数を入れていきます。
export type WordCount = { word: string; count: number };

const segmenter = new Intl.Segmenter('ja', { granularity: 'word' });
const HIRAGANA_ONLY = /^[\p{Script=Hiragana}ー]+$/u;

// 全角の英数字を半角に、英字を小文字にそろえる
export function normalize(word: string): string {
  return word.normalize('NFKC').toLowerCase();
}

// 文章を単語に分けて、単語ごとの回数を数える。多い順、同じ回数なら先に出てきた順
export function countWords(text: string, skipHiragana = false): WordCount[] {
  const counts = new Map<string, number>();
  for (const { segment, isWordLike } of segmenter.segment(text)) {
    if (!isWordLike) continue; // 句読点や空白、記号は数えない
    const word = normalize(segment);
    if (skipHiragana && HIRAGANA_ONLY.test(word)) continue;
    counts.set(word, (counts.get(word) ?? 0) + 1);
  }
  return [...counts]
    .map(([word, count]) => ({ word, count }))
    .sort((a, b) => b.count - a.count);
}
Intl.Segmenter は、呼ぶたびに作らず、ファイルの先頭で1つだけ作っています。
単語は、数える前に normalize('NFKC') と toLowerCase() でそろえます。NFKC は、互換の関係にある文字を同じ形にする正規化です(MDN の normalize() のページ)。全角の「CAT」は半角の「CAT」になり、小文字にすると「cat」も「Cat」も同じ単語として数えられます。
入力 "The cat sat. the Cat ran! CAT"
cat:3 the:2 sat:1 ran:1並べ替えは、回数の多い順だけを指定しています。Array.prototype.sort() は、ES2019 から安定ソート(同じ値の要素の順番が変わらない並べ替え)になると仕様で決まっています(MDN の sort() のページ)。Map は、キーを最初に入れた順に取り出せるので、同じ回数の単語は、文章の中で先に出てきた順に並びます。
助詞が上位に並ぶときは、ひらがなだけの語を除く
日本語の文章をそのまま数えると、「は」「で」のような助詞や、「ます」が上位に並びます。
入力 "猫は窓辺で眠る。猫は毎日よく眠る。"
  猫:2 は:2 眠る:2 窓辺:1 で:1 毎日:1 よく:1
入力 "猫は窓辺で眠る。猫は毎日よく眠る。"(ひらがなだけの語を除く)
  猫:2 眠る:2 窓辺:1 毎日:1
countWords() の2つ目の引数を true にすると、ひらがな(と長音の「ー」)だけでできた語を数えません。正規表現の \p{Script=Hiragana} は、Unicode のプロパティで文字を選ぶ書き方で、ひらがなの文字に一致します。上の例では、これで「は」「で」が表から消えました。その代わり、「よく」「ごはん」のようにひらがなで書いた語も一緒に消えます。
単語の区切りが、思った単位にならないところ
検証では、Intl.Segmenter が活用した語を辞書に載っている形(終止形)にまとめることはありませんでした。同じ動詞でも、形が変わると別の単語として数えられます。
入力 "猫が眠る。猫が眠った。猫は眠らない。"(ひらがなだけの語を除く)
  猫:3 眠:2 眠る:1
区切りをそのまま見ると、「眠った」は「眠」「っ」「た」、「眠らない」は「眠」「ら」「ない」に分かれていました。ひらがなの部分は除かれるので、「眠」が2回、「眠る」が1回になります。
ひらがなが続くところでは、区切りが単語とずれることもありました。
入力 "ねこと猫と犬。"
  ね:1 こと:1 猫:1 と:1 犬:1
入力 "東京都に行きました。"
東京:1 都:1 に:1 行き:1 ま:1 した:1「ねこと」は「ねこ」「と」ではなく「ね」「こと」に、「行きました」は「行き」「ま」「した」に分かれました。英字の識別子では、useState は1語のまま小文字の usestate に、use-state は use と state の2語になりました。
ひらがなだけの語を除くと、見本の文章でも「猫」「窓辺」のような名詞が表の上位に並びました。活用した語を1つにまとめて数えたいときは、Intl.Segmenter だけでは足りません。
回数を表にする React のコンポーネント
コンポーネントでは、文章とチェックの状態を state に持ちます。数えた結果は state にせず、レンダーのたびに countWords() で計算します。React の公式ドキュメントにある、既存の props や state から計算できるものは、レンダー中に計算するという考え方に沿った書き方です。
import { useId, useState } from 'react';
import { countWords } from './words';

const SAMPLE =
  '猫は窓辺で眠ります。朝になると、猫は台所に来て、ごはんを待ちます。' +
  'ごはんを食べた猫は、また窓辺に戻って眠ります。' +
  '雨の日の猫は、窓の外をじっと見ています。';

export function WordFrequency() {
  const [text, setText] = useState(SAMPLE);
  const [skipHiragana, setSkipHiragana] = useState(false);
  const textId = useId();

  const words = countWords(text, skipHiragana);
  const total = words.reduce((sum, w) => sum + w.count, 0);
  const top = words.slice(0, 10);

  return (
    <div className="word-frequency">
      <label htmlFor={textId}>文章</label>
      <textarea id={textId} rows={6} value={text} onChange={(e) => setText(e.target.value)} />

      <label>
        <input
          type="checkbox"
          checked={skipHiragana}
          onChange={(e) => setSkipHiragana(e.target.checked)}
        />
        ひらがなだけの語は数えない
      </label>

      <p className="summary">
        {total}語のうち、異なる語は{words.length}語です。
      </p>

      <table>
        <thead>
          <tr>
            <th scope="col">順位</th>
            <th scope="col">単語</th>
            <th scope="col">回数</th>
          </tr>
        </thead>
        <tbody>
          {top.map((w, i) => (
            <tr key={w.word}>
              <td>{i + 1}</td>
              <td>{w.word}</td>
              <td>{w.count}</td>
            </tr>
          ))}
        </tbody>
      </table>
    </div>
  );
}
表の行の key には、単語そのものを使いました。countWords() の結果では、同じ単語は Map で1つにまとまっているので、key が重なることはありません。
Chromium で操作したときの表示
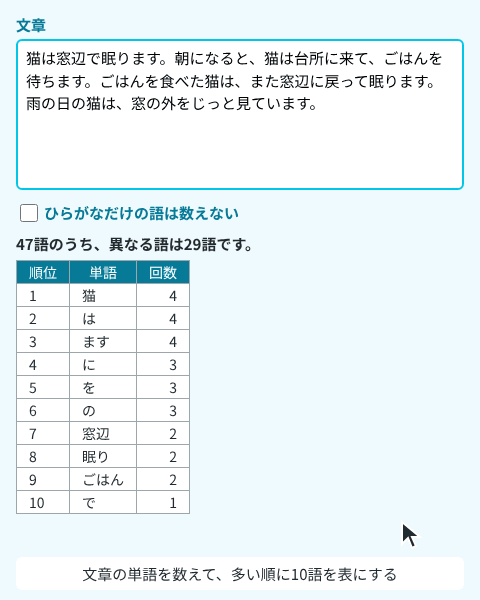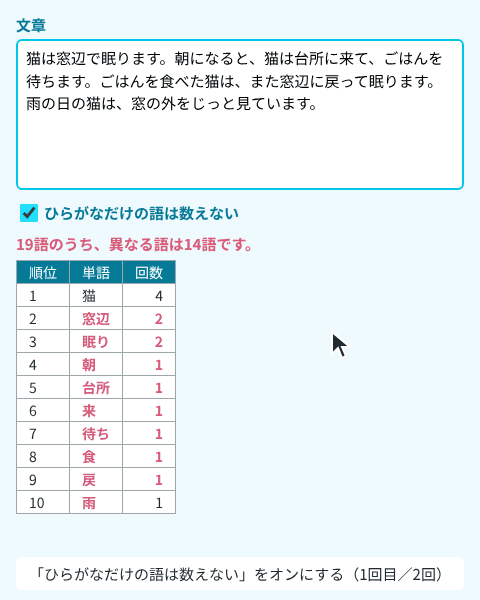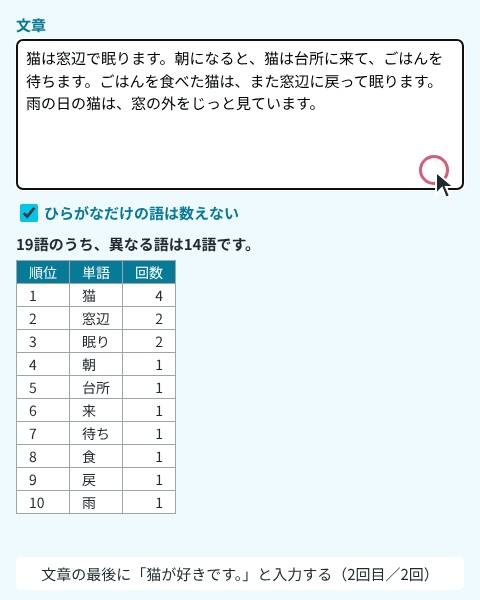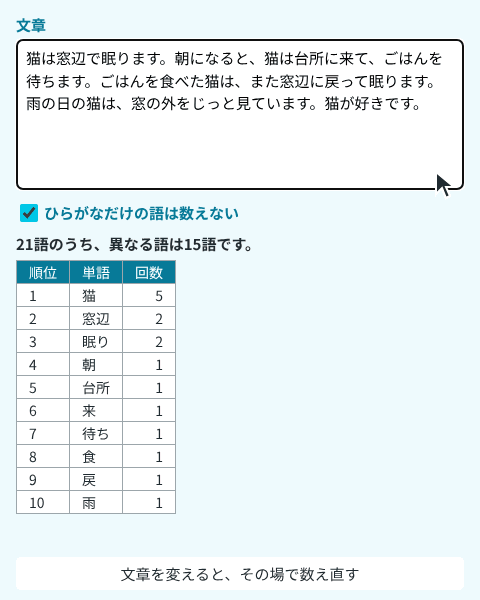
Playwright で入力欄とチェックボックスを操作し、そのつど要約の文と表の行を読みました。最初の表示では、「は」「ます」「に」などが上位に入りました。
--- 最初の表示
summary : 47語のうち、異なる語は29語です。
rows    : ["1 猫 4","2 は 4","3 ます 4","4 に 3","5 を 3","6 の 3","7 窓辺 2","8 眠り 2","9 ごはん 2","10 で 1"]
--- 「ひらがなだけの語は数えない」にチェック
summary : 19語のうち、異なる語は14語です。
rows    : ["1 猫 4","2 窓辺 2","3 眠り 2","4 朝 1","5 台所 1","6 来 1","7 待ち 1","8 食 1","9 戻 1","10 雨 1"]
チェックを入れると、ひらがなだけの語が消えて、19語・14種類になりました。「眠ります」は「眠り」と「ます」に、「食べた」は「食」と「べた」に分かれていたので、表には「眠り」と「食」が出ています。
続けて、文章の最後に「猫の名前はタマです。」と入力すると、猫が5回になり、要約は「22語のうち、異なる語は16語です。」に変わりました。チェックを外して、英語の文章 The cat sat. the Cat ran! CAT に入れ替えると、表は cat が3回、the が2回、sat と ran が1回になりました。文章を空にすると、要約は「0語のうち、異なる語は0語です。」になり、表の行はなくなりました。
長い文章で数える時間
文章を1文字変えるたびに、全体を数え直しています。検証環境の Node.js で測りました。コンポーネントに最初から入っている文章をくり返して長い文章を作り、countWords() に渡します。結果を使わない実行を3回してから、11回の時間を測りました。
10000字(6184語)を数える時間 中央値 4.4ms 最小 4.2ms 最大 4.5ms
100000字(61842語)を数える時間 中央値 59.3ms 最小 43.4ms 最大 80.8ms
1万字では、1回の数え直しが中央値で4.4ミリ秒でした。10万字では中央値で59.3ミリ秒でした。このコンポーネントでは、1文字入力するたびに、この数え直しが1回走ります。